Reference
油管:
https://www.youtube.com/watch?v=k5Rbi22TtOAwww.youtube.com/watch?v=k5Rbi22TtOA
Github:
https://github.com/steineggerlab/foldseekgithub.com/steineggerlab/foldseek
安装
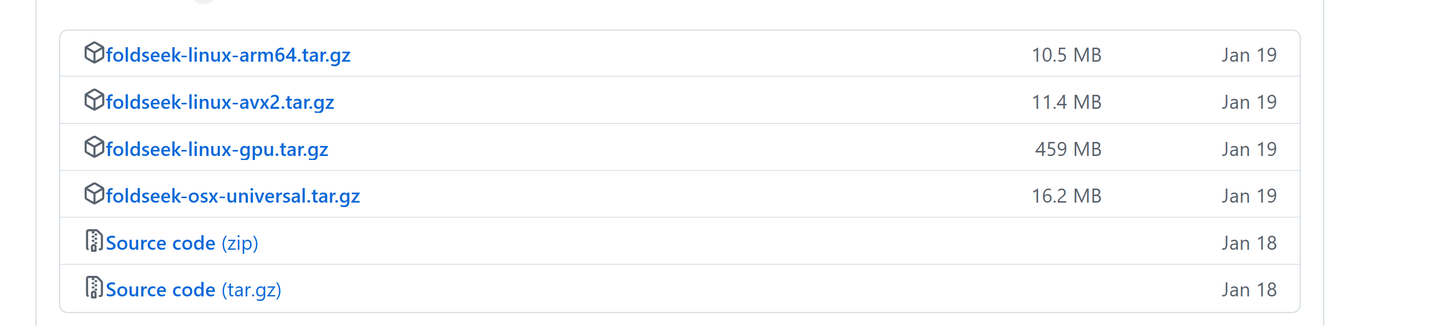
可以直接从release page上得到链接(注意可以下载那个带-gpu的),然后wget
https://github.com/steineggerlab/foldseek/releases
添加图片注释,不超过 140 字(可选)
wget gpu-link
tar -xvzf foldseek-linux-avx2.tar.gz
export PATH=$(pwd)/foldseek/bin:$PATH
foldseek version
准备好fasta 文件,可以cluster
foldseek databases ProstT5 prostt5_weights tmp # 下载weights 到prostt5_weights
foldseek createdb proteins.fasta protein_db --prostt5-model prostt5_weights --gpu 1 #创建db
foldseek easy-cluster protein_db cluster_out tmp -c 0.9 # 进行cluster
下面这个work
foldseek easy-cluster full_kinase_seq.fasta cluster_out tmp --prostt5-model prostt5_weights --gpu 1 -c 0.9
看了一下结果,fasta file的这个非常不好用,结果不太对,不建议用fasta文件做。
# Linux AVX2 build (check using: cat /proc/cpuinfo | grep avx2)
wget https://mmseqs.com/foldseek/foldseek-linux-avx2.tar.gz; tar xvzf foldseek-linux-avx2.tar.gz; export PATH=$(pwd)/foldseek/bin/:$PATH

# Linux SSE4.1 build (check using: cat /proc/cpuinfo | grep sse4_1)
wget https://mmseqs.com/foldseek/foldseek-linux-sse41.tar.gz; tar xvzf foldseek-linux-sse41.tar.gz; export PATH=$(pwd)/foldseek/bin/:$PATH

# MacOS
wget https://mmseqs.com/foldseek/foldseek-osx-universal.tar.gz; tar xvzf foldseek-osx-universal.tar.gz; export PATH=$(pwd)/foldseek/bin/:$PATH

# Conda installer (Linux and macOS)
conda install -c conda-forge -c bioconda foldseek
如果不知道自己是哪个system,可以用cat /proc/cpuinfo | grep avx2来查AVX2, 或者下面这个来查SSE4
cat /proc/cpuinfo | grep sse4_1
创建Database
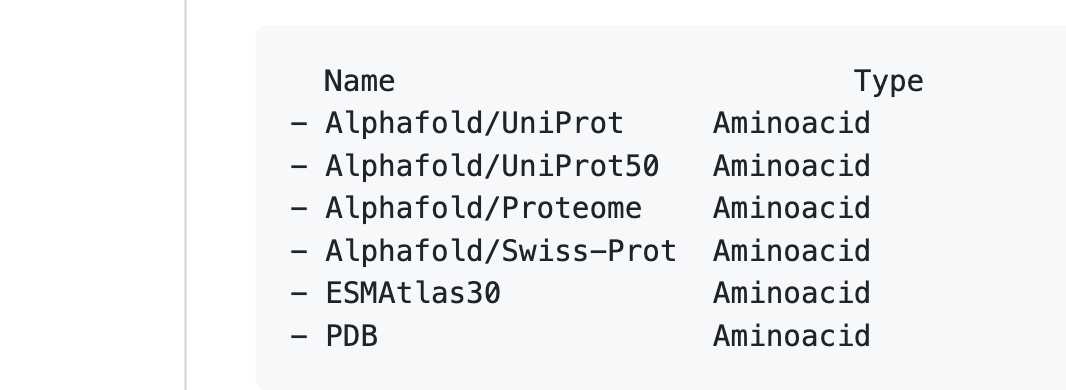
可以直接用现成的
添加图片注释,不超过 140 字(可选)
command是
foldseek databases 【database 名称】 【database本地保存的名字】 【database本地存放的文件夹名字】
比如
foldseek databases Alphafold/Swiss-Prot sp tmp
(这个database 几个G)
Create Index (optional),我也不知道这步干啥的,但教学视频里说了。
foldseek createindex 【database本地保存的名字】 【database本地存放的文件夹名字】
foldseek createindex sp temp
也可以自定义数据库
以后有时间补充一下
搜索
foldseek easysearch 【pdb文件名】【database本地保存的名字】【输出align的名字】【database本地存放的文件夹名字】
比如
foldseek easy-search 3bis.pdb sp human_pdl1 tmp
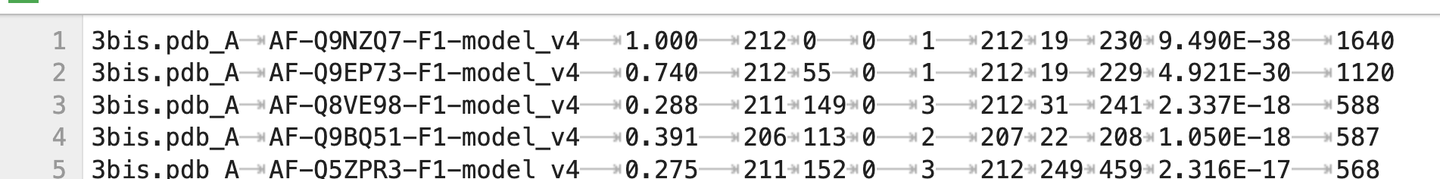
输出的文件,这里是human_pdl1如下:
添加图片注释,不超过 140 字(可选)
里面的顺序按照结构相似度排列,每行中的第一个是query pdb文件,第二个是数据库里的蛋白,第三个是相似度,第四个和第五个是query pdb align的起始和终点,然后是target 的起始和终点,之后是关于random的叫e value,还有一个叫bits的score。
也可以把e value那一列(倒数第二列)换成TM分数
比如
foldseek easy-search 3bis.pdb sp human_pdl1 tmp --alignment-type 1
除了上面default的输出,也就是:
--format-output query,target,fident,alnlen,mismatch,gapopen,qstart,qend,tstart,tend,evalue,bits
还可以通过在后面添加添加额外的输出
比如
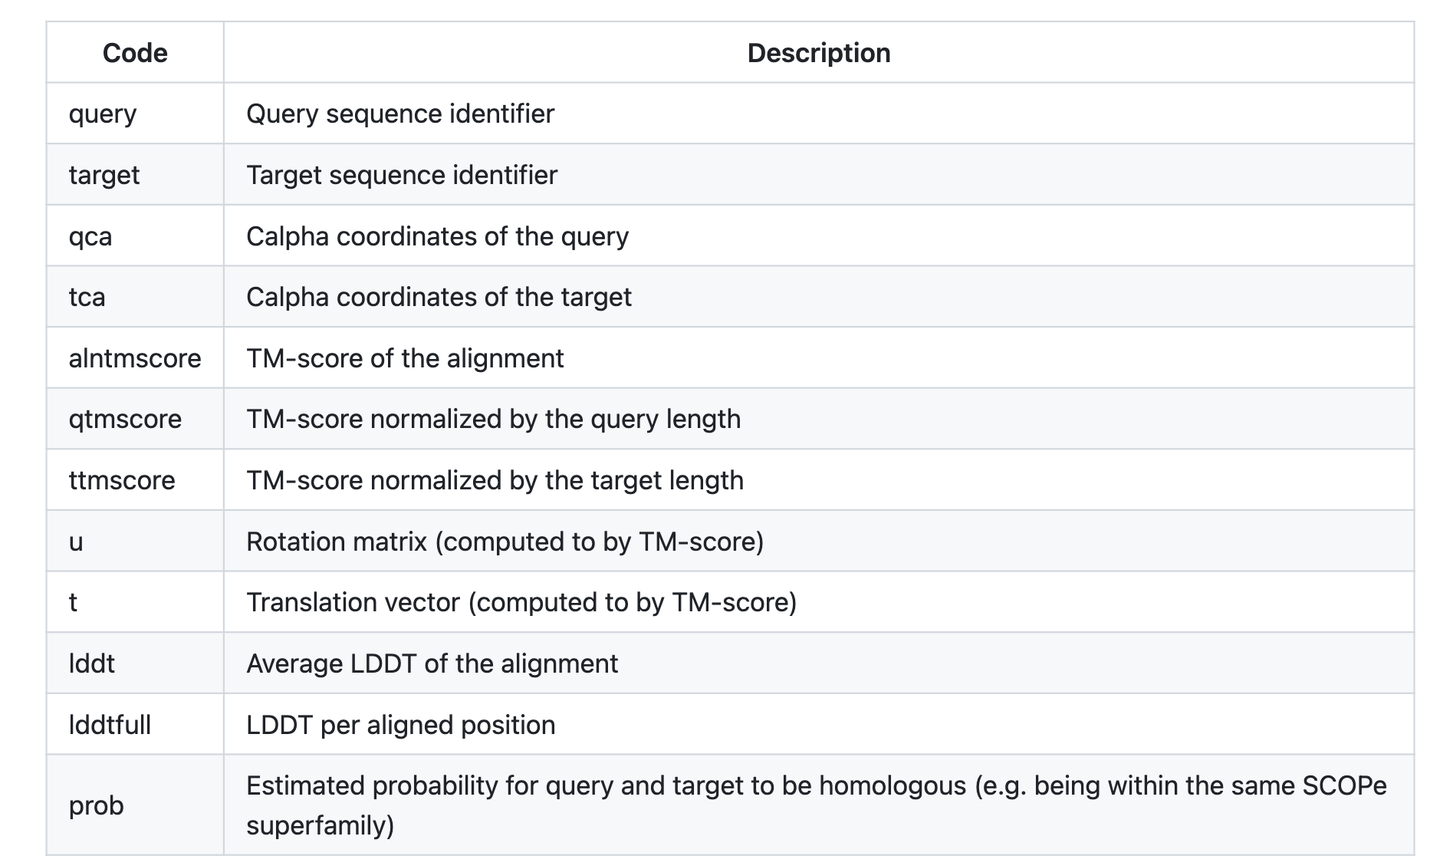
prob,lddt,alntmscore,qtmscore,ttmscore,
这个是available的score
添加图片注释,不超过 140 字(可选)
全部都要的话,可以把刚才的command改成
foldseek easy-search 3bis.pdb sp human_pdl1 tmp --format-output query,target,fident,alnlen,mismatch,gapopen,qstart,qend,tstart,tend,evalue,bits,prob,lddt,alntmscore,qtmscore,ttmscore
Lddt分数在这里是利用了alphafold里lddt的公式,只不过用在了计算query和target蛋白之间(每个氨基酸)的差距。
不同于tm分数(template Modeling score)以及rsmd分数,lddt不需要依靠superposition。所以有些情况,tm分数低,但是lddt分数高,是因为某个蛋白有多个domain,然后中间的linker使得它们的旋转方向不同,而这导致query蛋白和数据库中的蛋白无法superimpose,所以它的tm分数不会高,但是lddt分数却很高。
也可以看网页输入,把刚才的输出加个.html,然后加个--format-mode 3
比如
foldseek easy-search 3bis.pdb sp human_pdl1.html tmp --format-mode 3
也可以把pdb文件作为输出,还是刚才的输出名,不过后面改成--format-mode 5
比如
foldseek easy-search 3bis.pdb sp human_pdl1 tmp --format-mode 5
注意:如果你的数据库很大,请不要做这一步,因为这会导致当前目录出现上百万个output pdb文件。