TACC skill
-
uniprot-kd得到protein seq
-
在AF server上跑seq,下载,得到unpaired msa.a3m
-
和tacc-2step skill说这个file,copy-rename 它到 input folder
-
提供SMILES ,和a3m的path,准备input json files
-
跑skill,提供密码和MFA tacc 6 digits token
另外不需要提供template,也不用让它自动搜索template("templates":null 会自动搜索,每次会去前四个cif), template只影响protein folding,不影响ligand
Setup
克隆git repo
git clone https://github.com/google-deepmind/alphafold3.git
安装af_kit
pip install -U git+https://github.com/sky1ove/af_kit.git
Model weights
申请weights,填下面的表格
https://docs.google.com/forms/d/e/1FAIpQLSfWZAgo1aYk0O4MuAXZj8xRQ8DafeFJnldNOnh_13qAx2ceZw/viewform
收到weights之后,在alphafold3的parent目录下,新建一个af_model文件夹,把weights放进去。
Enable resume
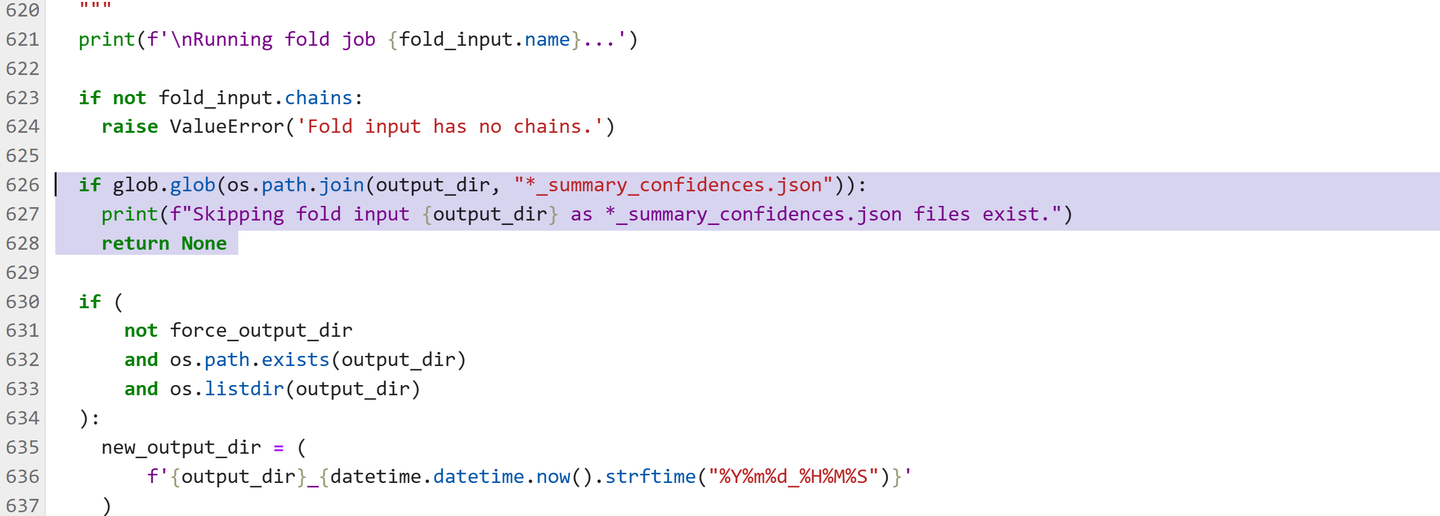
打开run_alphafold.py 然后在process_fold_input 里面添加:
def process_fold_input():

  print(f'Processing fold input {fold_input.name}')

  if not fold_input.chains:
    raise ValueError('Fold input has no chains.')

  if glob.glob(os.path.join(output_dir, "*_summary_confidences.json")):
    print(f"Skipping fold input {output_dir} as *_summary_confidences.json files exist.")
    return None
添加图片注释,不超过 140 字(可选)
这样如果文件夹里已经有summary confidences (也就是说之前已经跑出结果), 就可以skip这个case
Docker
Update docker hub
建立一个setup.sh文件
#!/bin/bash

cd alphafold3
git pull origin main
docker build -t alphafold3 -f docker/Dockerfile .

docker login -u docker_username -p docker_password
docker tag alphafold3 sky1ove/alphafold3
docker push sky1ove/alphafold3
把它改成可执行的
chmod +x setup.sh
运行
./setup.sh
Pull docker
docker pull sky1ove/alphafold3
MSA数据库
MSA可以只在cpu上跑,不需要gpu
下载af3 msa数据库
在alphafold3的parent目录中,建立一个af_db的文件夹
cd alphafold3  # Navigate to the directory with cloned AlphaFold 3 repository.
./fetch_databases.sh af_db
大概六七百个gb,记得预留足够的位置。
MSA跑的往往很慢(半个小时左右一个蛋白)。如果有大量的蛋白要测,可以用colabfold MSA (后面)
不下载数据库(有a3m和template search结果)
virtual screen pipeline
开一个新的vm。 通常只有一个蛋白(前面用大的数据库的vm已经跑过了),但对应很多小分子化合物。
只下载mmcif (仅有a3m和需要跑template search)
protein-protein study pipeline
开一个新的vm。
如果已经提前计算好MSA,但需要template search,可以只用下载mmcif。
参考alphafold3/fetch_databases.sh 文件 做一个fetch_mmcif.sh 文件。
这里把db_dir设置成了af_db
#!/bin/bash

set -euo pipefail

readonly db_dir="$HOME/af_database"

for cmd in wget tar zstd ; do
  if ! command -v "${cmd}" > /dev/null 2>&1; then
    echo "${cmd} is not installed. Please install it."
  fi
done

echo "Fetching databases to ${db_dir}"
mkdir -p "${db_dir}"

readonly SOURCE=https://storage.googleapis.com/alphafold-databases/v3.0

echo "Start Fetching and Untarring 'pdb_2022_09_28_mmcif_files.tar'"
wget --quiet --output-document=- \
    "${SOURCE}/pdb_2022_09_28_mmcif_files.tar.zst" | \
    tar --no-same-owner --no-same-permissions \
    --use-compress-program=zstd -xf - --directory="${db_dir}"
在terminal 运行 ./fetch_mmcif.sh
如果只需要RNA的,那么也可以只下载RNA数据库。
Colabfold MSA
在一个只有cpu的vm里,安装
pip install "colabfold[alphafold] @ git+https://github.com/sokrypton/ColabFold"
准备一个有如下格式的csv
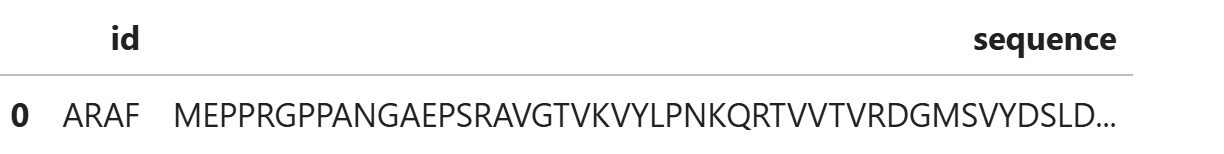
添加图片注释,不超过 140 字(可选)
然后在parent目录新建一个folder,比如msa_{project_name}
colabfold_batch seq.csv msa_{project_name} --msa-only
运行完之后,复制到有gpu的地方
copy_a3m(a3m_dir=f'/teamspace/studios/alphfold3/msa_{project_name}',
         dest_dir=f'af_input/{project_name}/msa')
Tutorials
Covalent
ligand.sdf
到pubchem上直接下载2d的conformer就可以,AF预测会自动转换成3d,另外如果没有leaving atom,只是双键变单键,不需要额外修改。输出的结构是没有双键信息的,需要经过protein prepare pipeline才可以。
Old
embeddings
在command中加入--save_embeddings=true
json input format
sequences 是个list [], 里面protein也有sequence,注意是单数,前面的是复数。
{
  "name": "Job name goes here",
  "modelSeeds": [1, 2],  # At least one seed required.
  "sequences": [
    {"protein": {...}},
    {"rna": {...}},
    {"dna": {...}},
    {"ligand": {...}}
  ],
  "bondedAtomPairs": [...],  # Optional
  "userCCD": "...",  # Optional
  "dialect": "alphafold3",  # Required
  "version": 2  # Required
}
Sequences 里面各项的format
Protein
第二版可以加入unpairedMsaPath
  "protein": {
    "id": "A",
    "sequence": ...,
    "unpairedMsaPath": "The A3M MSA path",
    "pairedMsa": "",
    "templates": [] if skip or None(python)/null if run
}
Run 全部 (MSA+templates)
json的依据是,如果不想跑,就放一个空的“”或者[],如果想跑,用null或者不放进去。
只放sequence,其余默认为null,也就是run
"protein": {
  "id": "A",
  "sequence": ...,
}
run MSA,但不search templates
templates没有就用[]
"protein": {
  "id": "A",
  "sequence": ...,
  "templates": []
}
这和加入 "pairedMsa": null, "unpairedMsa": null, 效果是一样的
放入precalculated MSA 但不search templates (不推荐)
templates设置为[]
  "protein": {
    "id": "A",
    "sequence": ...,
    "unpairedMsa": "The A3M MSA",
    "pairedMsa": "",
    "templates": []
}
放入precalculated MSA,但也跑templates (推荐)
把templates设置成null,或者干脆把这行去掉。
  "protein": {
    "id": "A",
    "sequence": ...,
    "unpairedMsa": "The A3M MSA",
    "pairedMsa": "",
    "templates": null
}
Environment
Docker file里面已经加入了
ENV XLA_FLAGS="--xla_gpu_enable_triton_gemm=false"
ENV XLA_PYTHON_CLIENT_PREALLOCATE=true
ENV XLA_CLIENT_MEM_FRACTION=0.95
如果超过5120 token,比如用一个A100 40GB的,很容易超出RAM, 这个时候可以在docker文件里加入下面的,可以让多出来的memory进入host memory,但与之而来的是更慢的速度。所以还是尽量控制token不要超过5120.
ENV XLA_PYTHON_CLIENT_PREALLOCATE=false
ENV TF_FORCE_UNIFIED_MEMORY=true
ENV XLA_CLIENT_MEM_FRACTION=3.2
General json input
sequences 是个list [], 里面protein也有sequence,注意是单数,前面的是复数。
{
  "name": "Job name goes here",
  "modelSeeds": [1, 2],  # At least one seed required.
  "sequences": [
    {"protein": {...}},
    {"rna": {...}},
    {"dna": {...}},
    {"ligand": {...}}
  ],
  "bondedAtomPairs": [...],  # Optional
  "userCCD": "...",  # Optional
  "dialect": "alphafold3",  # Required
  "version": 2  # Required
}
Sequences 里面各项的format
Protein:
{
  "protein": {
    "id": "A",
    "sequence": "PVLSCGEWQL",
    "modifications": [
      {"ptmType": "HY3", "ptmPosition": 1},
      {"ptmType": "P1L", "ptmPosition": 5}
    ],
    "unpairedMsa": ...,
    "pairedMsa": ...,
    "templates": [...]
  }
}
关于提前算好的MSA
放到unpairedMsa里,需要在pairedMsa里放"", 和空的templates: []
{
  "protein": {
    "id": "A",
    "sequence": ...,
    "unpairedMsa": "The A3M you want to run with",
    "pairedMsa": "",
    "templates": []
  }
}
Ligand, 用逗号隔开
{
  "ligand": {
    "id": "J",
    "ccdCodes": ["LIG-1337"]
  }
},
{
  "ligand": {
    "id": "K",
    "smiles": "CC(=O)OC1C[NH+]2CCC1CC2"
  }
}
single tasks 用--json_path, multiple tasks 用--input_dir
CPU data pipeline - generate MSA only
docker run --rm \
    --volume $HOME/af_input:/root/af_input \
    --volume $HOME/af_msa:/root/af_msa \
    --volume $HOME/af_models:/root/models \
    --volume $HOME/database:/root/public_databases \
    alphafold3 \
    python run_alphafold.py \
    --input_dir=/root/af_input \
    --model_dir=/root/models \
    --output_dir=/root/af_msa \
    --norun_inference
GPU inference, skip MSA
if adding --norun_data_pipeline, it will skip template search.
if remove --norun_data_pipeline, and json file have template as null, it will first search template
docker run --rm \
    --volume "$HOME/af_input:/root/af_input" \
    --volume "$HOME/af_output:/root/af_output" \
    --volume "$HOME/af_model:/root/models" \
    --volume "$HOME/af_database:/root/public_databases" \
    --volume "$HOME/cache:/root/cache" \
    --gpus all \
    sky1ove/alphafold3 \
    python run_alphafold.py \
    --input_dir=/root/af_input \
    --model_dir=/root/models \
    --output_dir=/root/af_output \
    --jax_compilation_cache_dir=/root/cache \
    --save_embeddings=true
MSA的output和一开始的input很像,就是多了
一开始的input
[{'protein': {
   'id': ['A', 'B'],
   'sequence': 'GMRESYANENQFGFKTINSDIHKIVIVGGYGKLGGLFARYLRASGYPISILDREDWAVAESILANADVVIVSVPINLTLETIERLKPYLTENMLLADLTSVKREPLAKMLEVHTGAVLGLHPMFGADIASMAKQVVVRCDGRFPERYEWLLEQIQIWGAKIYQTNATEHDHNMTYIQALRHFSTFANGLHLSKQPINLANLLALSSPIYRLELAMIGRLFAQDAELYADIIMDKSENLAVIETLKQTYDEALTFFENNDRQGFIDAFHKVRDWFGDYSEQFLKESRQLLQQANDLKQG'}}]
MSA后的json多了modifications, unpairedMsa, pairedMsa, templates
[{"protein": {
        "id": "A",
        "sequence": "GMRESYANENQFGFKTINSDIHKIVIVGGYGKLGGLFARYLRASGYPISILDREDWAVAESILANADVVIVSVPINLTLETIERLKPYLTENMLLADLTSVKREPLAKMLEVHTGAVLGLHPMFGADIASMAKQVVVRCDGRFPERYEWLLEQIQIWGAKIYQTNATEHDHNMTYIQALRHFSTFANGLHLSKQPINLANLLALSSPIYRLELAMIGRLFAQDAELYADIIMDKSENLAVIETLKQTYDEALTFFENNDRQGFIDAFHKVRDWFGDYSEQFLKESRQLLQQANDLKQG",
        "modifications": [],
        "unpairedMsa": ">query\nGMRESYA.....
        "pairedMsa": ">query\nGMRESYA.....
        "templates": [{'mmcif': 'data_3GGG\n#\n_entry.id 3GG....
Docker container
docker run --rm \
    --volume $HOME/af_input:/root/af_input \
    --volume $HOME/af_output:/root/af_output \
    --volume $HOME/af_weights:/root/models \
    --volume $HOME/af_database:/root/public_databases \
    --gpus all \
    ....
--rm 确保推出之后自动删掉container
-it, i是iterative,t是。。
--volumn , or -v, 是mount,本地:container里
container 里default路径是/root,
可以设置working directory, -w /app
后面加上bash 可以让terminal 一直保持docker environment
exit可以退出 container
手动delete image
docker rmi alphafold3
MSA
pip install "colabfold[alphafold] @ git+https://github.com/sokrypton/ColabFold"
colabfold_batch file.csv folder_name --msa-only
file.csv的格式是第一列是id, 第二列是sequence