notes
resolution
2.8A 中低quality,一定要查看 reliability report,主要看missing loops and steric clashes,如果不在 CDR 上,可以勉强 pass
想要 protein engineering,需要 <=2
protein interaction analysis
calculate后,会给glycan/ligand周围自动加水
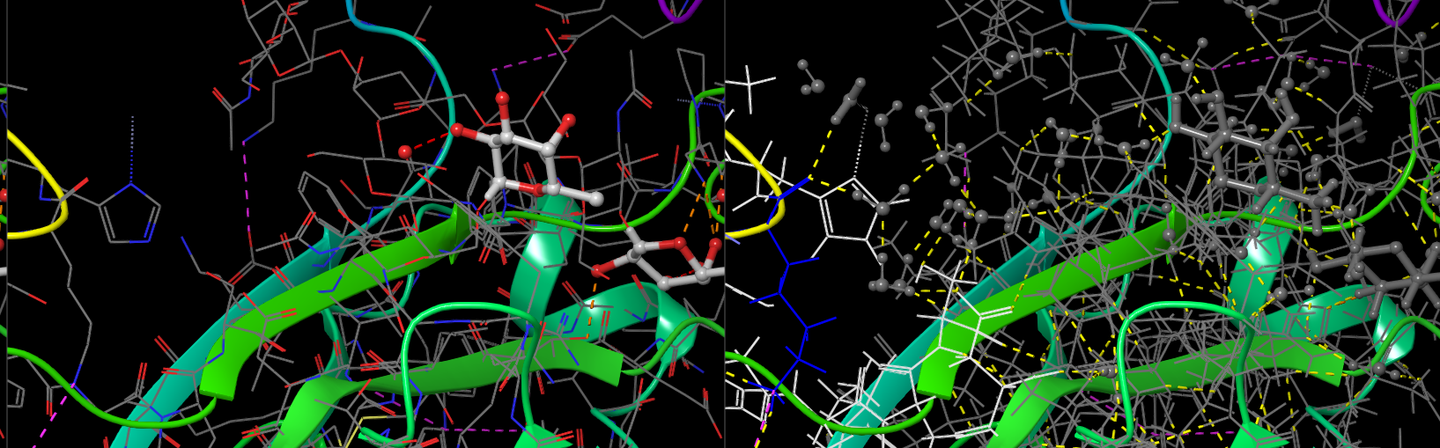
右边加了很多水
另外,chain name 不能是两个letter,否则会报错
change residue number
不能双击下面的sequence选中,因为只会选中部分,要用左侧的hierarchy选中
pdb里面不要改starting number,因为有的时候会有gap,改完会打乱这些residue number
protein prep
每次先移除solvant(ACT[acetate],GOL[glycerol]),保留金属(Zn)
basics
set working directory
change working directory每次都太麻烦,可以直接去preference设置
edit - preference - Directories - default directory for job startup - others 设置一下,一般是在一个大folder里面
save as a project, 在folder里,重命名即可。
更改鼠标控制
workspace - customize mouse actions
maestro的default是3 buttons&scroll
zoom放大选中atom
选择一个atom,点击auto(蓝色highlight)即可

添加图片注释,不超过 140 字(可选)
选中residue/secondary structure
双击residue,可以选中整个chain
左上角的default选择是R(residue),如果改成Secondary Structure,可以同时选择一部分residue(如下图,是选中了a-helix的residues)
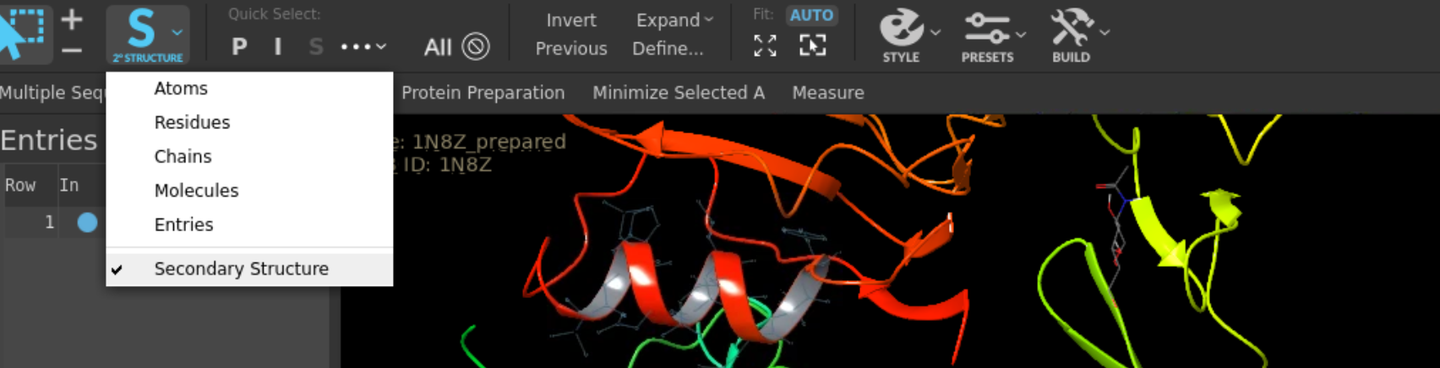
添加图片注释,不超过 140 字(可选)
选中protein-protein-interface
左上角的I,然后style换成那个一坨一坨的显示即可。

添加图片注释,不超过 140 字(可选)
也可以在...里有更多的options
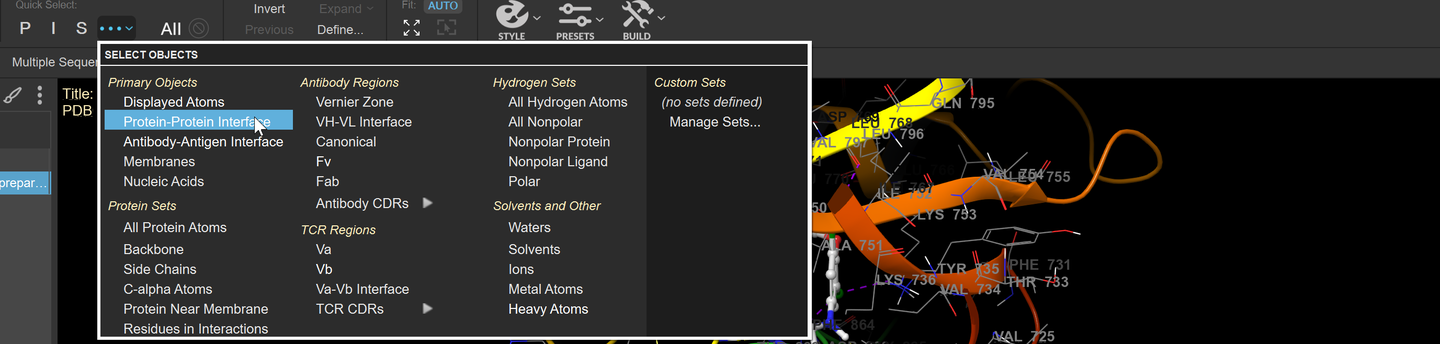
添加图片注释,不超过 140 字(可选)
把atom或ribbon颜色改成b-factor
改atom颜色
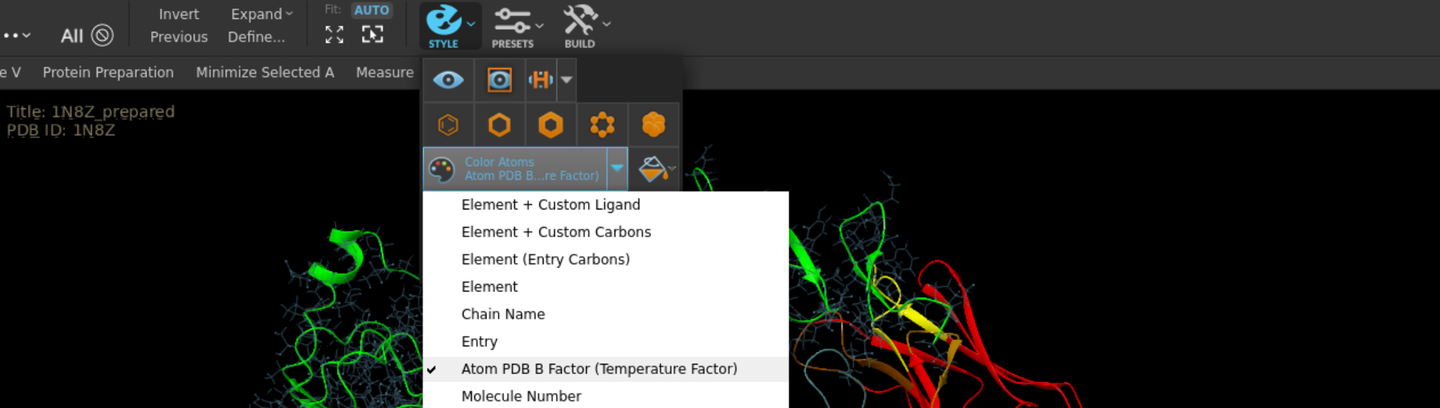
添加图片注释,不超过 140 字(可选)
改ribbon颜色
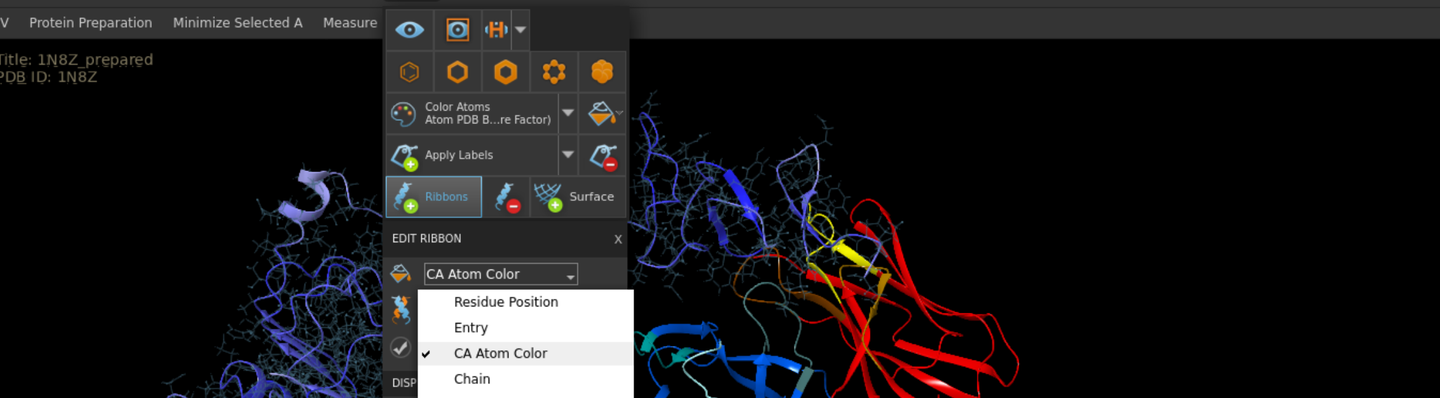
添加图片注释,不超过 140 字(可选)
如果pdb里有glycan想要更好看的show出来,可以直接设置ribbons的color为CA Atom Color
打开/关上atom visualize
选中chain之后,点一下那个大眼睛就会显示atom或者不显示了
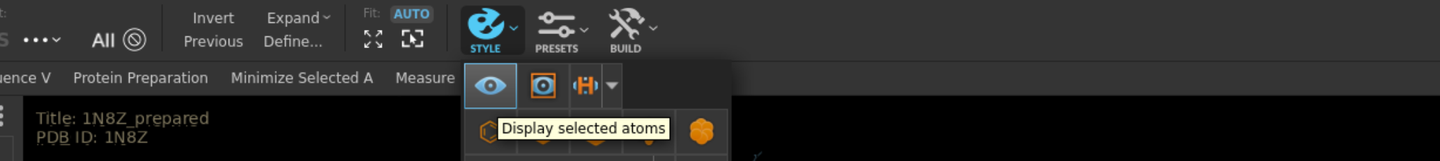
添加图片注释,不超过 140 字(可选)
Ab style
presets - antibody - chothia , 这样antigen就是绿色的,heavy是蓝色,light是红色,yellow是CDR
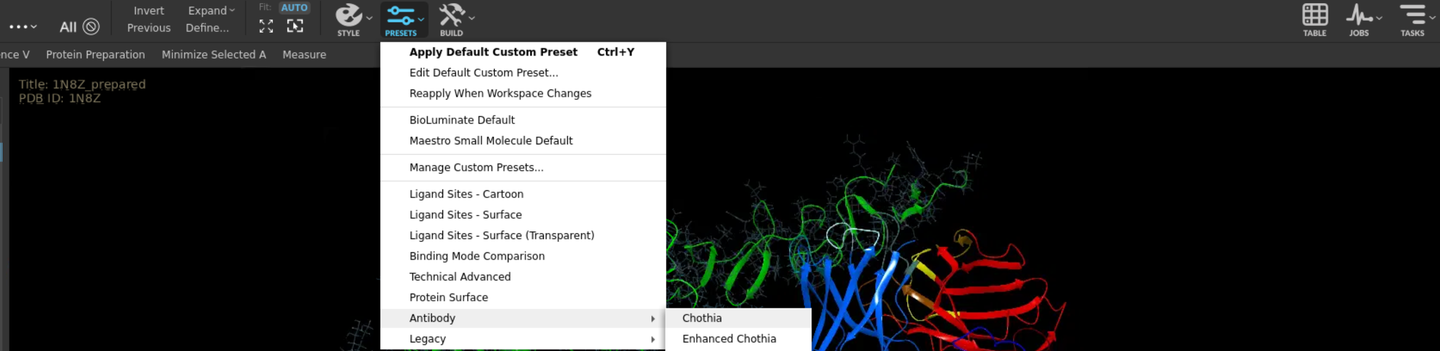
添加图片注释,不超过 140 字(可选)
如果比较两个entry,那就workspace选中两个,然后再chothia
surface
presets - protein surface , 可以增加surface。如果设置transparency,然后和electrostatic颜色,左侧nav bar的entry边上会出现一个S,点击- display options,就可以设置了。在color scheme里也可以选别的property。
如果要隐藏,右下角toggle可以,左侧entry旁边的小图标也可以隐藏。
如果要具体surface分析,那就用task里的 protein surface analysis (following content)
tiling
workspace选中多个,然后右下角,点亮Tile。
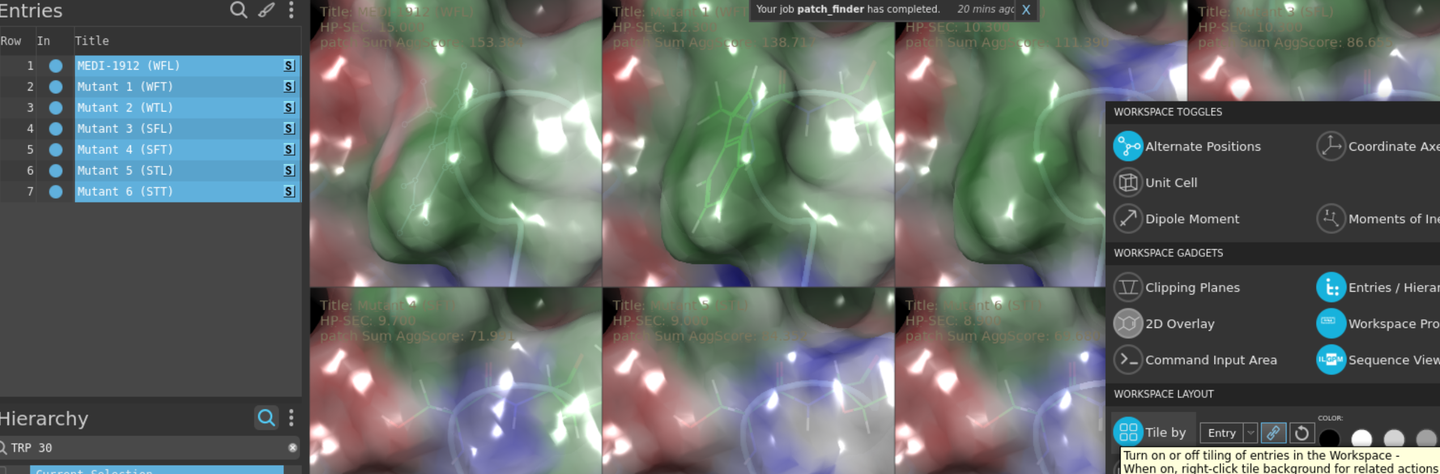
添加图片注释,不超过 140 字(可选)
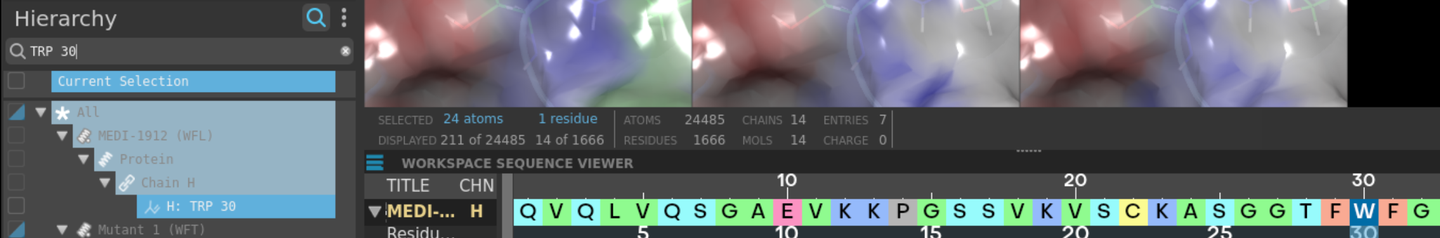
hierarchy 左侧,输入TRP 30, 选择第一个之后,点击最上面的auto,可以zoom in
添加图片注释,不超过 140 字(可选)
右键tile左上角的title,edit workspace properties,点击add,可以添加你想要显示的分数。这里添加了HP-SEC和patch Sum AggScore

添加图片注释,不超过 140 字(可选)
画scatterplot
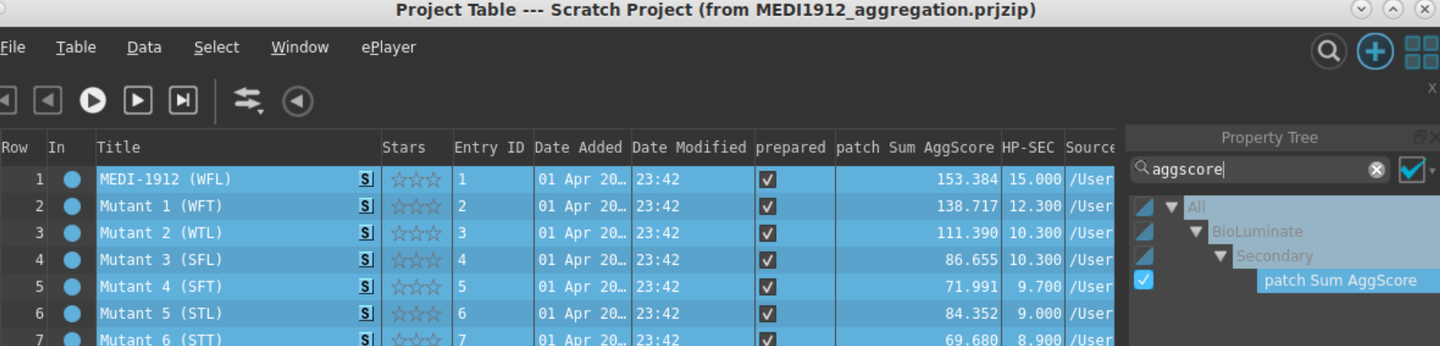
右上角的table, 之后再project table里的右侧,添加算好的分数,这里是aggscore
添加图片注释,不超过 140 字(可选)
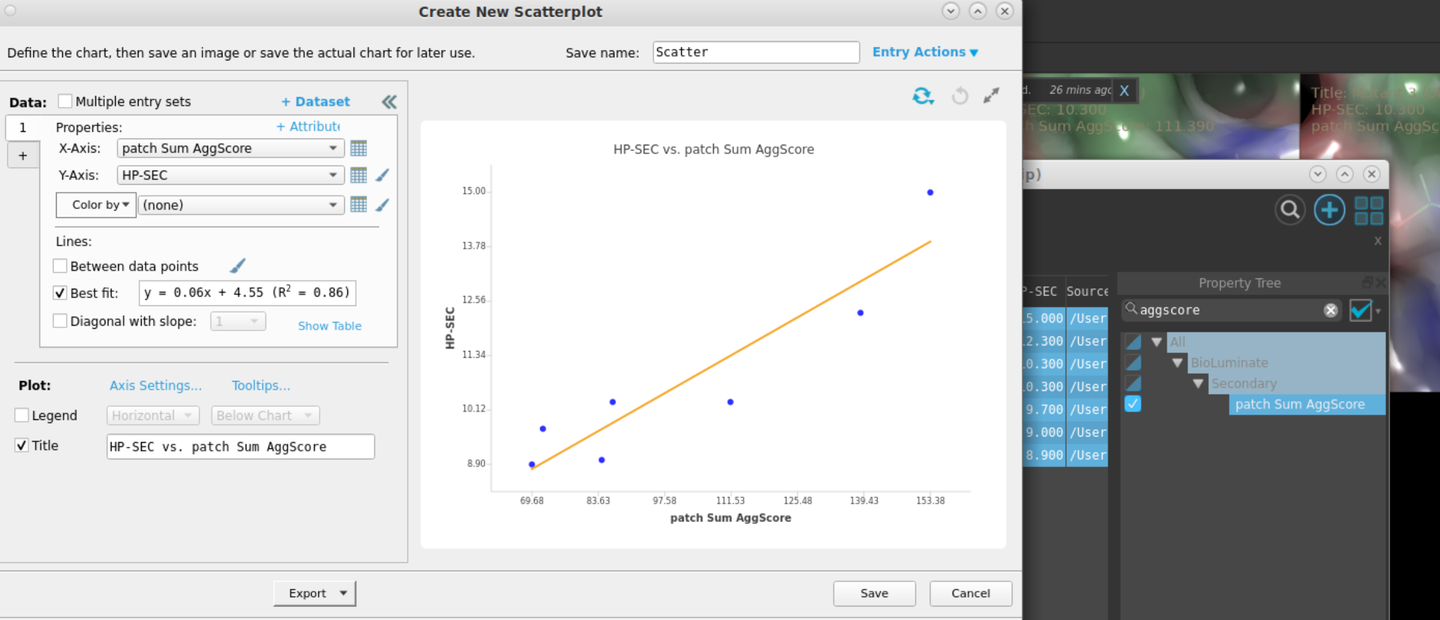
选中所有的行,之后点击窗口右上角的四个方块,chart manager - create - scatterplot
输入x axis和y axis, check best fit, check Title
添加图片注释,不超过 140 字(可选)
Pipelines
protein prep
先改成interactive。
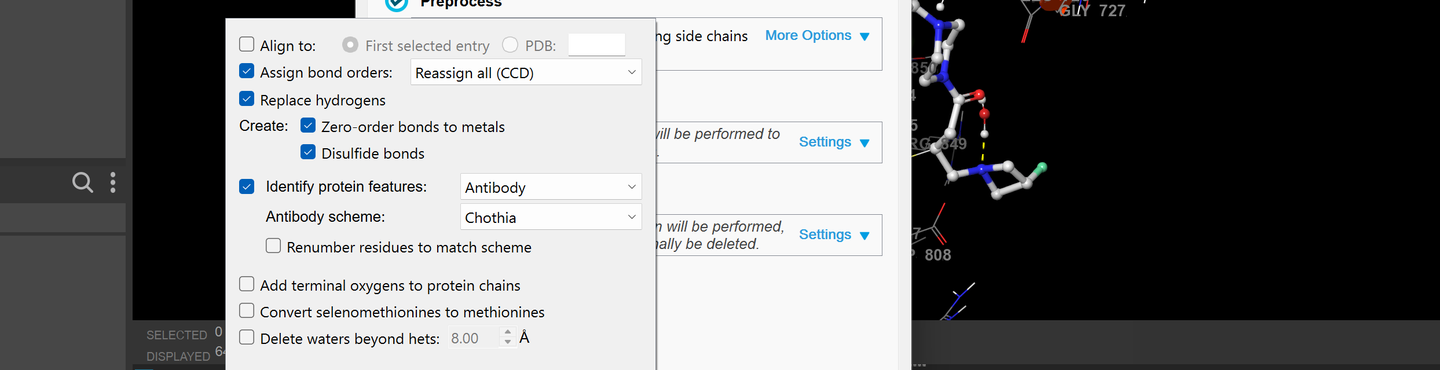
之后2.preprocess - more options - 如果是antibody,就选中identify protein feature,然后里面是antibody,然后antibody scheme:改成chothia
添加图片注释,不超过 140 字(可选)
之后在下面选中Fill in missing loops(using Prime)
点击preprocess
- diagnose and analyze - 点击check structure
- optimize H bond assignments,点击optimize
- Minimize and delete waters, 点击clean up
Protein reliability report
prepare完protein之后,打开protein reliability report, run一个job。
跑完之后会有提示,点击open。
最先关注的三个是missing loops, missing atoms, steric clashes
点击steric clash,右侧没东西出来,那就选中show crystal mate clashes就会出现,但一般如果只是在mates里,就没关系。
最不用关注的是buried unsatified donor/acceptor, unusual b-factors, peptide planarity, improper torsions
pdb resolution会爆红有时候是因为这个pdb resolution>2.5A (数值越小,分辨率越高。低于1.5是非常高,2.8-3.5是较差)
change chain name
Build--other edits -- change atom properties - chain name,选中每个chain,依次改成A(antigen), H(heavy), L(light)
Protein structure alignment
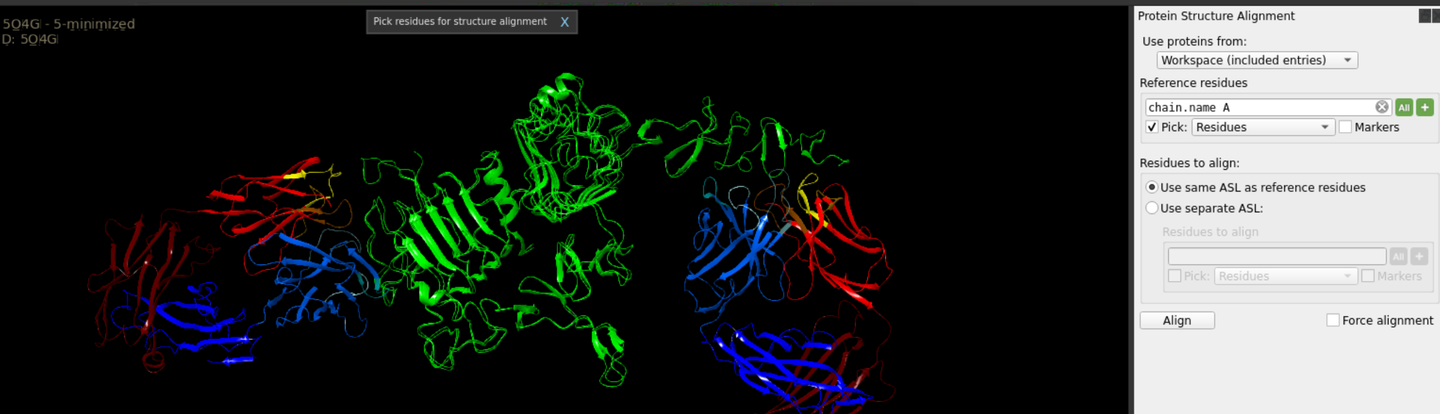
两个entry(两个不同的ab bind在同一个antigen上),那可以用antigen chain align
protein structure alignment - 在右侧的reference residues输入chain.name A即可
添加图片注释,不超过 140 字(可选)
可以看到两个Ab结合在抗原不同的位置上。
Protein interaction analysis
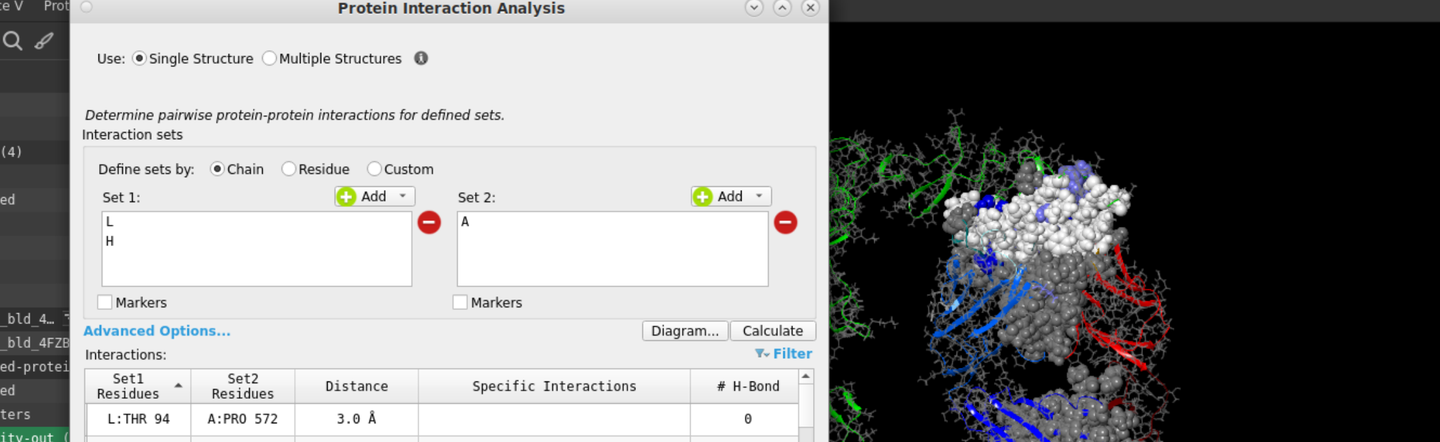
Set1 添加L,H,set2添加A。左侧的advanced options可以设置多大的距离内认定为interaction,这里是4A,也可以设置别的。
点击右侧的calculate,表格会出现具体的interaction info,然后右侧会highlight atom。表格可以点击export tables来保存interaction。
添加图片注释,不超过 140 字(可选)
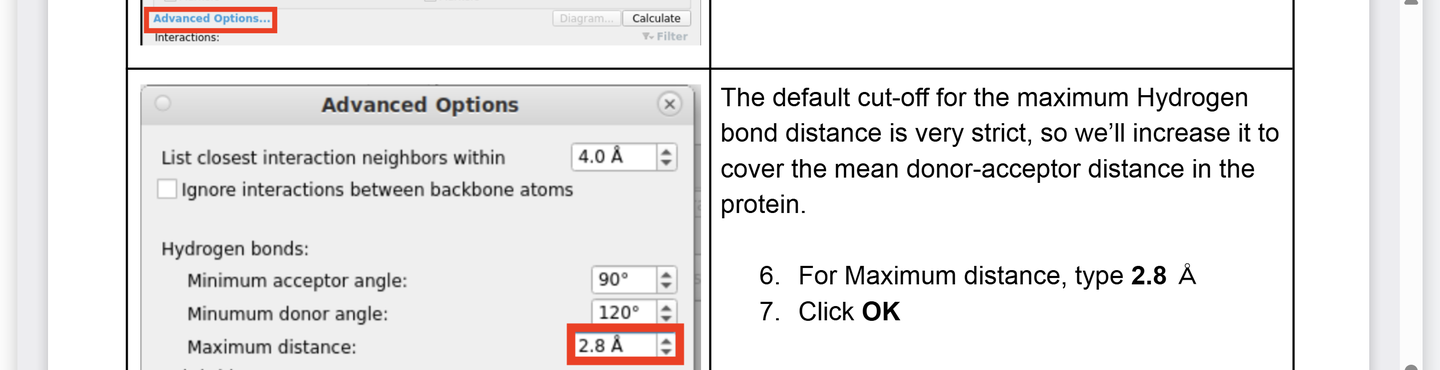
可以点击advanced options,然后把距离设置稍大一些,2.8A
添加图片注释,不超过 140 字(可选)
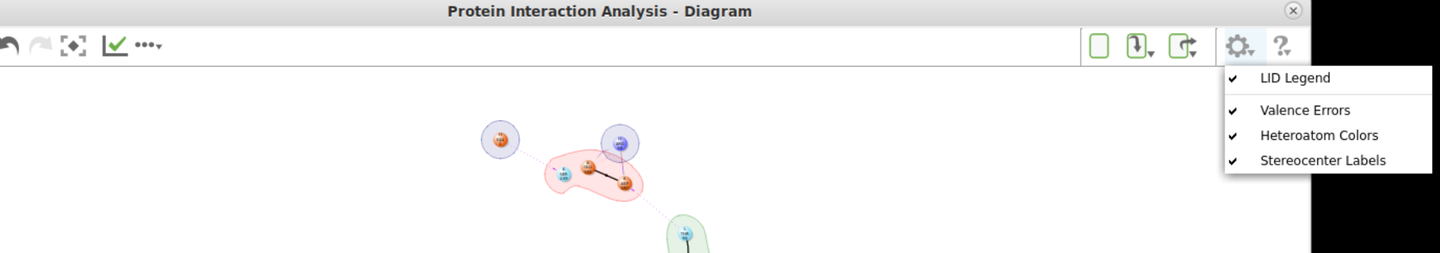
点击Diagram,可以看到interaction 图(记得选中LID Legend,就可以显示每个bond代表什么了)
添加图片注释,不超过 140 字(可选)
Ab structure prediction
准备好.fasta文件
task - antibody structure prediction
load fasta文件(有两段seq),会自动识别VH还是VL,同一个文件分别load进去
右上角还有ML prediction,可以选择(会花更多的时间,选择和不选择都可以跑,然后reliability report看哪个更好)。ML用的算法是AntibodyBuilder2,会预测五个好像,然后选一个average的。
framework,default直接run,主要看composite score,至少在0.8以上才可以。
右下角绿色loop进入到下一步。
loop,会运行寻找相似的loop,之后运行前记得把cpu改到最好的,然后run
之后会在entry里有一个预测的结构,一般CDR-H3的variability是最大的,如果之前的loop similarity不高,需要refine antibody loops(通常会跑一天)
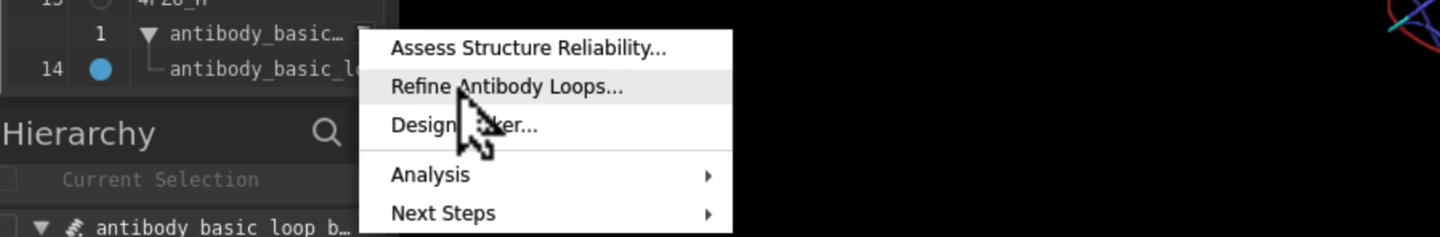
添加图片注释,不超过 140 字(可选)
Assess structure reliability
点击上面的第一个reliability,命名job name,run
之后会有report,看missing loops/atoms, steric clashes,如果steric clashes里面的aa不在CDR附近,就没关系。如果在附近,打开protein prep,跑minimize & delete water 那一步即可。
Protein surface analyzer
可以分析agg score (根据aa hydrophobicity),来推断它哪里会aggregates(self-associate)
workspace 选中 - protein surface analyzer - analyze - aggregation - AggScore
在workspace显示color,就在下面的color by 选择AggScore
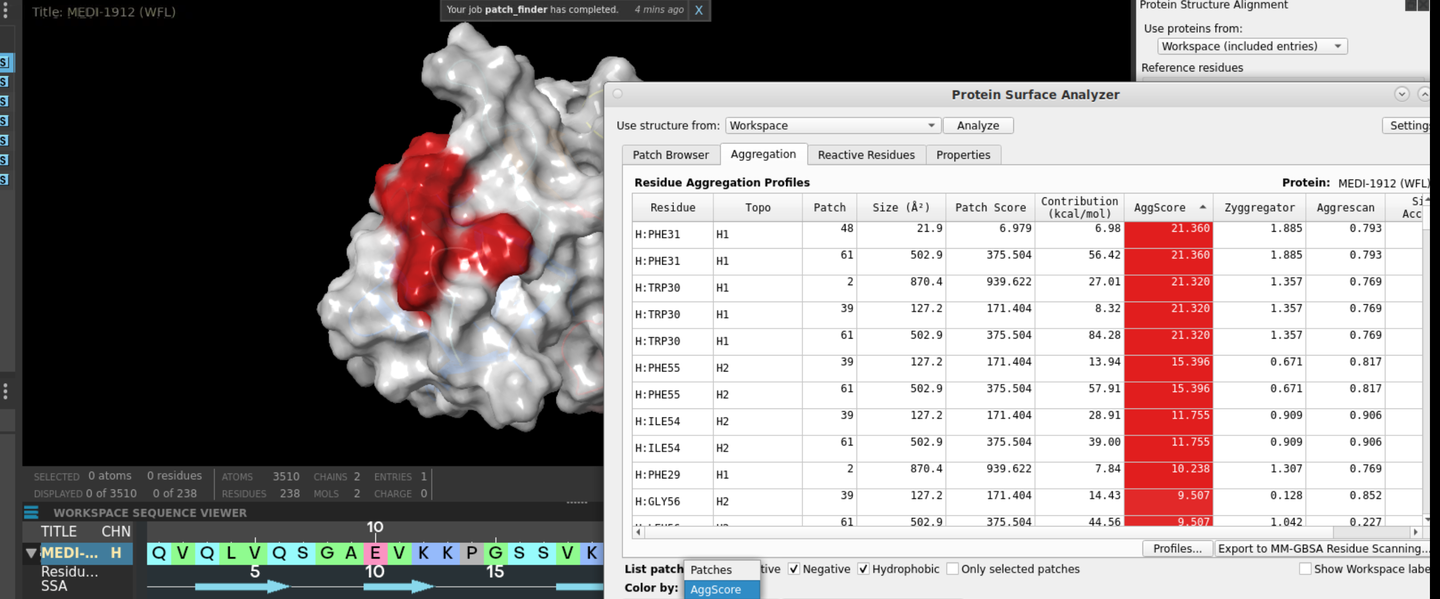
添加图片注释,不超过 140 字(可选)
默认的patch(片区)分为pos(蓝色),neg(红色),hyd(绿色)
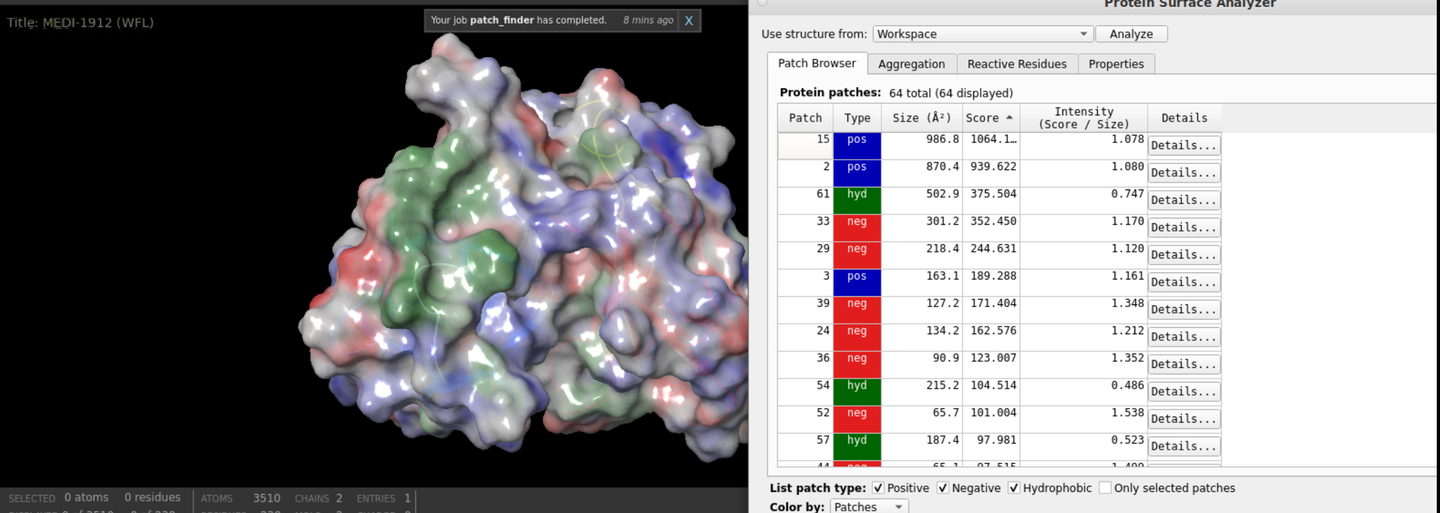
添加图片注释,不超过 140 字(可选)
另外也可以看看Reactive residues,里面有post-translational modification,比如deamination之类的。
Multiple Sequence Viewer
homologs里可以blast PDB或者NR(non-redundant,指的是去重的pdb)
Select - sequence by feature - antibody heavy chain/light chain - 然后放到new tab里
一般来讲,light chain,heavy chain,antigen各一个tab。然后每个tab里align,查看哪些residue conserve。
align,可以右键设置set reference,然后根据那个reference align sequence,可以做Multiple sequence alignment也可以根据structure align。
annotation
右下角的bar图的三个点,可以check各种选项,就会加上annotation
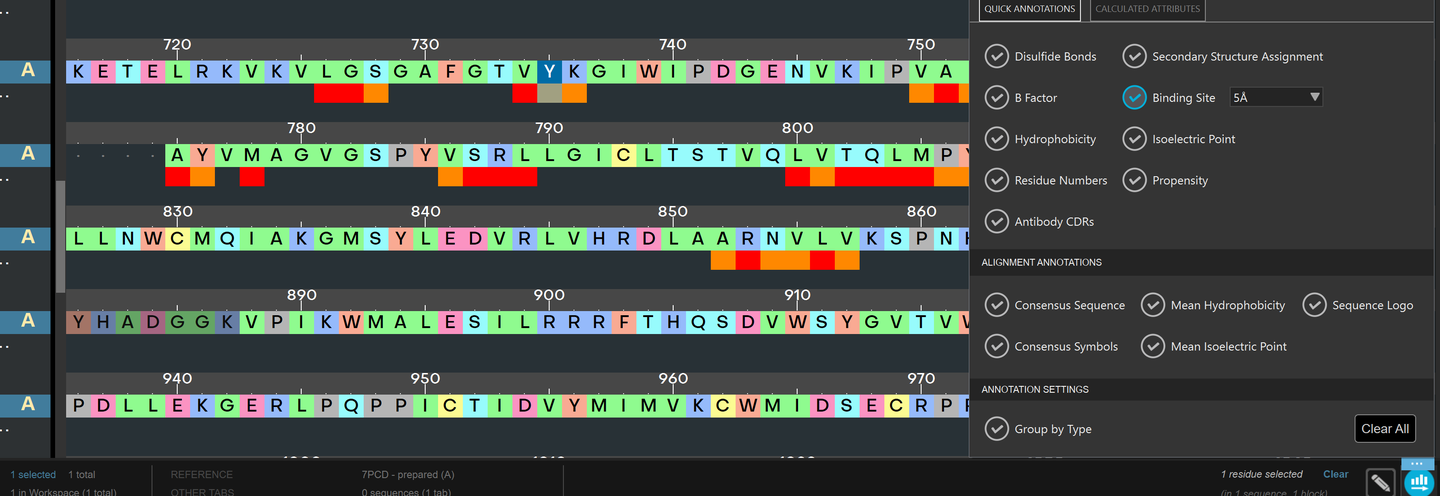
添加图片注释,不超过 140 字(可选)
如果要 extract 抗体的 VH 和 VL 来制作 scFv( VH-3xG4S - VL)
进入到calculate annotation, 找到Features 右侧的 calculate features, 然后如下图选中 antibody regions, Chothia,然后不要选择 identify features for selected sequences only,之后确认,即可显示。
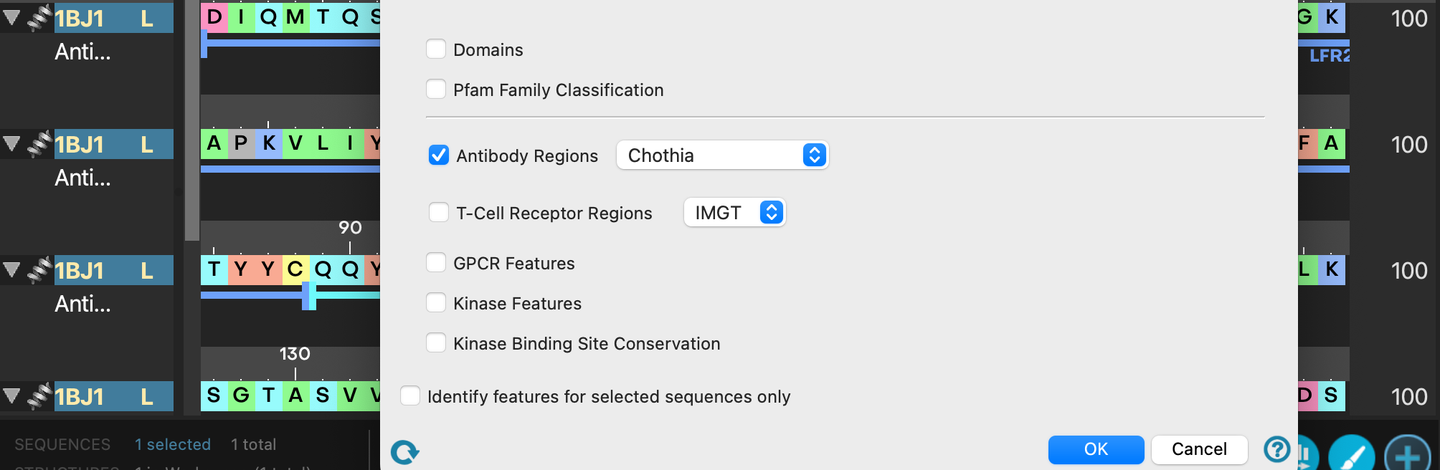
添加图片注释,不超过 140 字(可选)
HFR = Heavy chain Framework Region, 轻链同理。H1/H2/H3是 CDR 区域。
residue color
右下角的画笔的三个点,可以设置color by,会给residue加上颜色,然后可以apply到worksapce上。
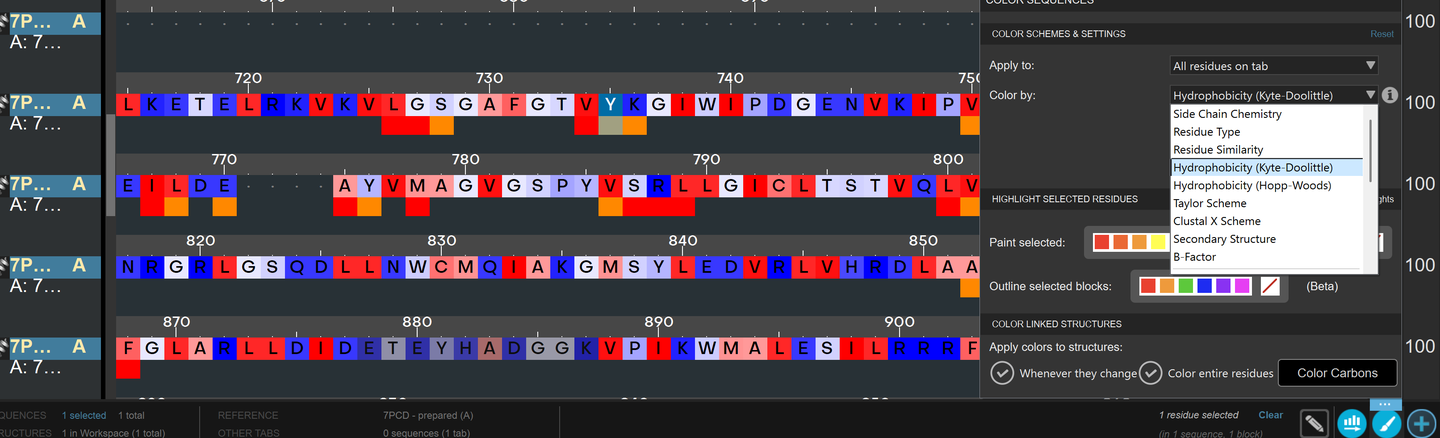
添加图片注释,不超过 140 字(可选)
MM-GBSA residue scanning
import, 选中stability and affinity(如果无法选择是因为没有import first),然后deselect antigen,之后indicate哪些mutation,还可以allow simultaneous,然后在mutations里选single或者double。
跑完之后,会出一个表格,Δ Affinity >3 或者<-3都表示会影响binding,>3意味着binding减弱,反之亦然。
Paratop prediction
paratop,是抗体上的位点(用来和抗原结合的地方)
PIPER算法,rigid docking
先prepare antibody 和antigen,Ag可以在pdb里面找,然后antibody可以让schrodinger预测结构,也可以让AF来预测(或者直接预测全部来比较)。
protein-protein docking: 选中antibody, 然后再structures to dock里的antibody的小三角点击,可以选择workspace或者project table,之后选择antigen的,然后run
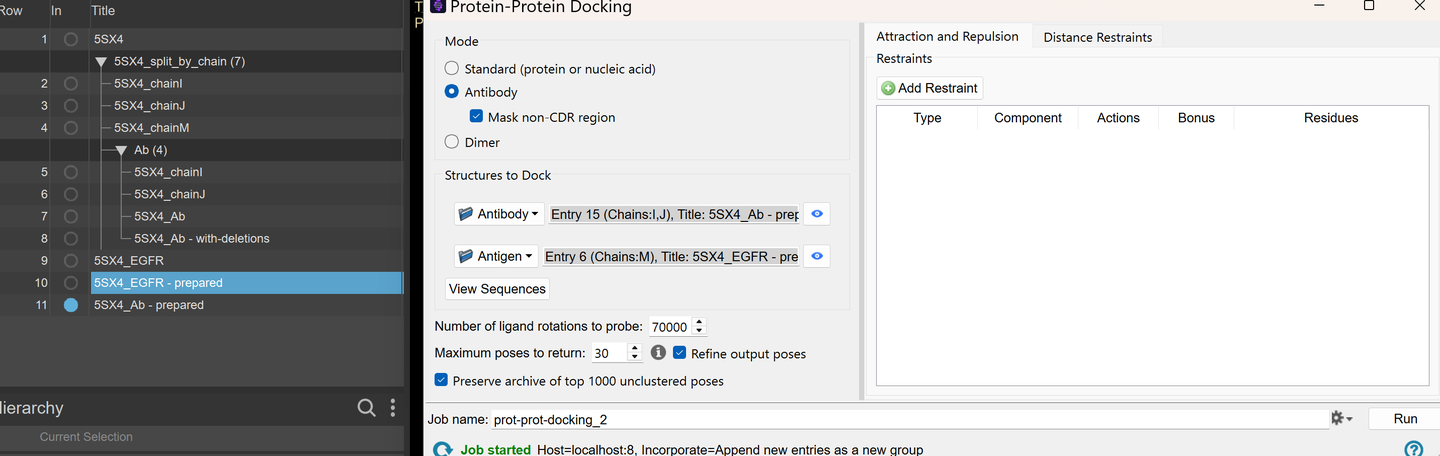
添加图片注释,不超过 140 字(可选)
这里会预测7w个poses,然后cluster,找到里面30个cluster centroids显示。
Interaction Fingerprints
查看抗体上的哪些位点在pose中出现的频率高。
上面预测的那些poses里,如果能找到一些Ab里面经常会interact的residue,可以帮助更好的设计Ab和optimize它。
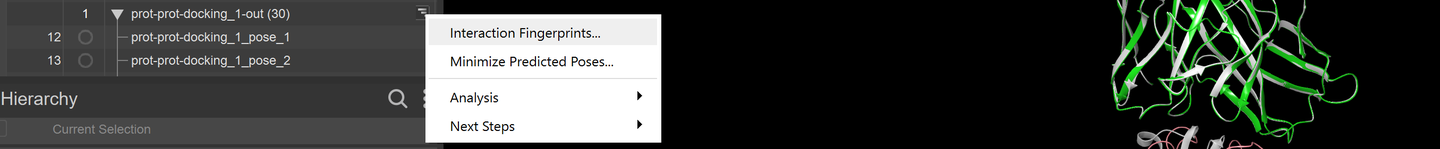
添加图片注释,不超过 140 字(可选)
pose1和target是最接近的
workspace选中这些output的poses,打开interaction fingerprints,选择protein-protein complexes, 然后deselect 抗原,选中的是抗体(这里的H是heavy chain,nanobody只有一个heavy chain),然后generate fingerprints
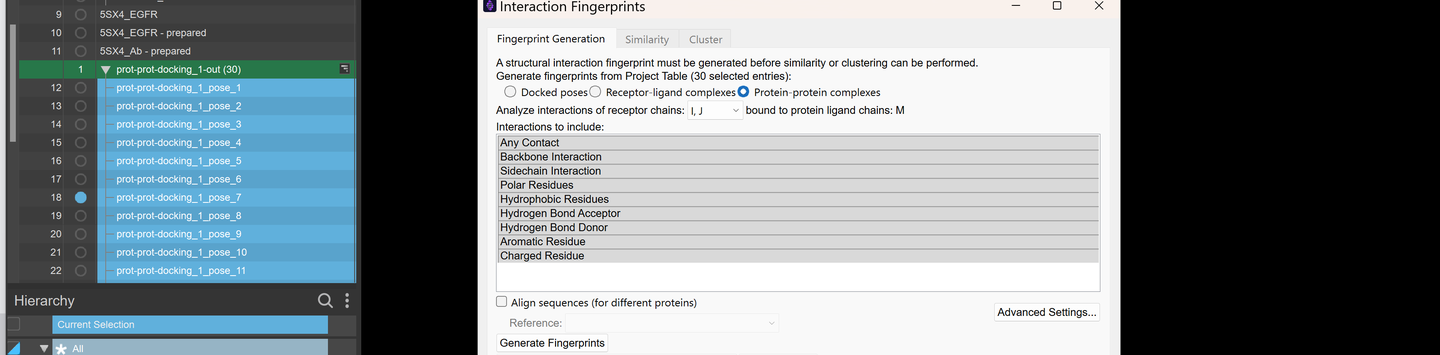
添加图片注释,不超过 140 字(可选)
等一会儿,跑完会出现display interaction matrix,点击就能看到matrix了。
在下面选中Interacting residues only
重点看最上面的bar graph, 这里显示I32, I91,I92, J32,33,35,37,38,39, J102,103在**抗体里(I和J chain)**是会可能和Ag interact的。
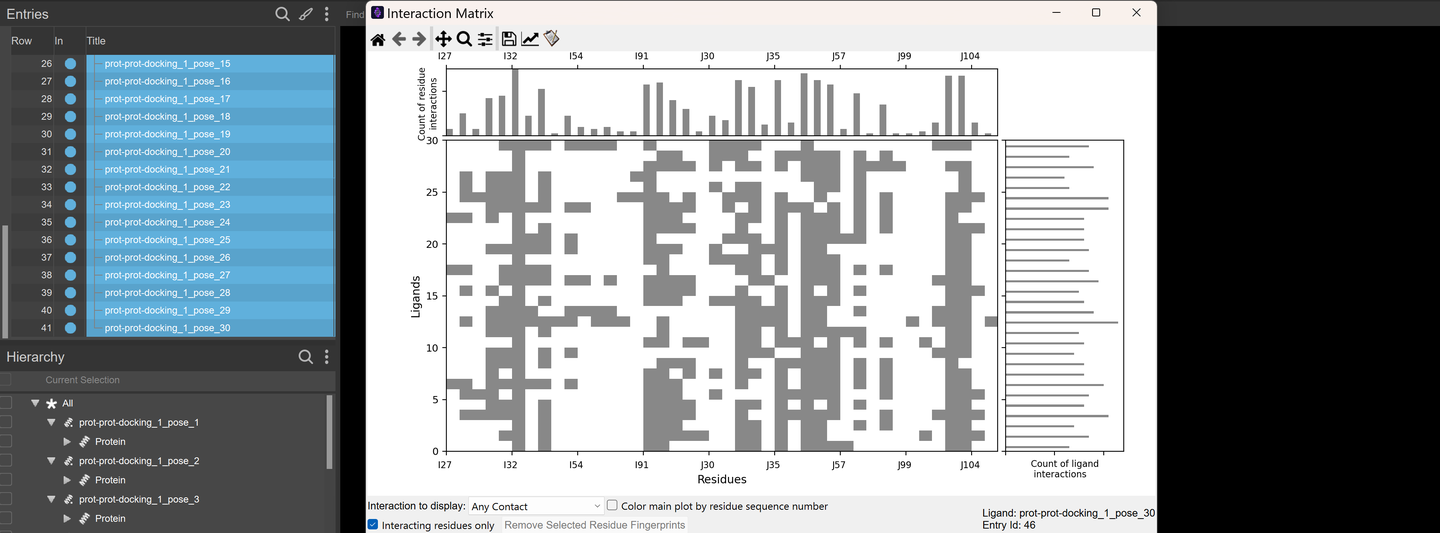
添加图片注释,不超过 140 字(可选)
Humanize
- 先得到heavy 和 light 的结构。
- protein prep, 确保kabat scheme,然后 renumber一定要选中!!(不然后面 back mutate 会出错)
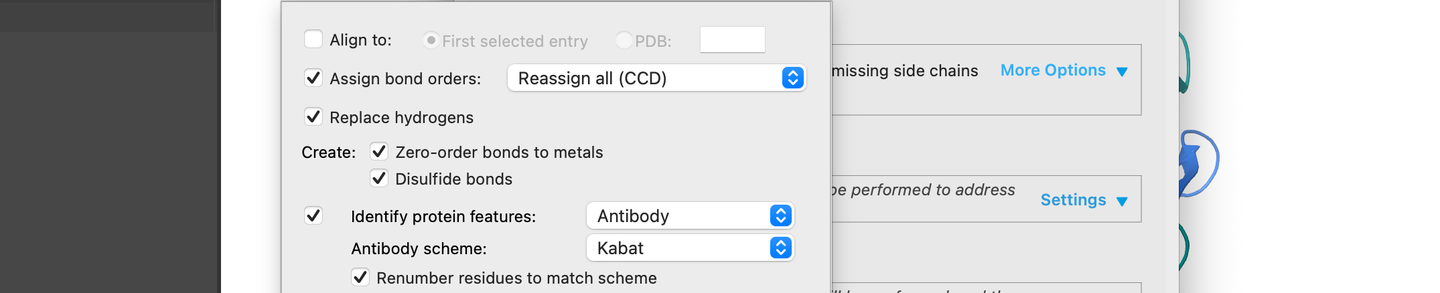
添加图片注释,不超过 140 字(可选)
- task --> humanization-CDR panel
import from workspace, 然后再 framework from Structural database 选中 Load
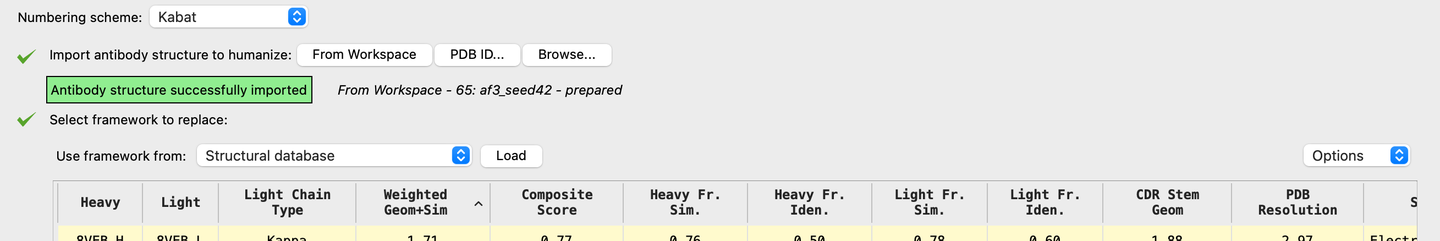
添加图片注释,不超过 140 字(可选)
weighted geom+Sim 越小越好(geom 是 structural alignment,sim 是 seq alignment),把<2 的都截图照下来。然后从第一个选中,然后点击replace Framework。
下面 backmutate 的部分,如果有显示 residues,他们如果 query 是同一个 residue,不用理会。如果是不同的,mutate 到 query 的 residue。
- export的时候,在左侧选中所有的 entry(不是 workspace),右键 export -spreadsheet,然后在 properties 里选中 selected,然后选择 select,然后按住 command 键(好多选),找到 Title, Heavy seq, Light sea, Human % (H), Human % (L). 然后 save
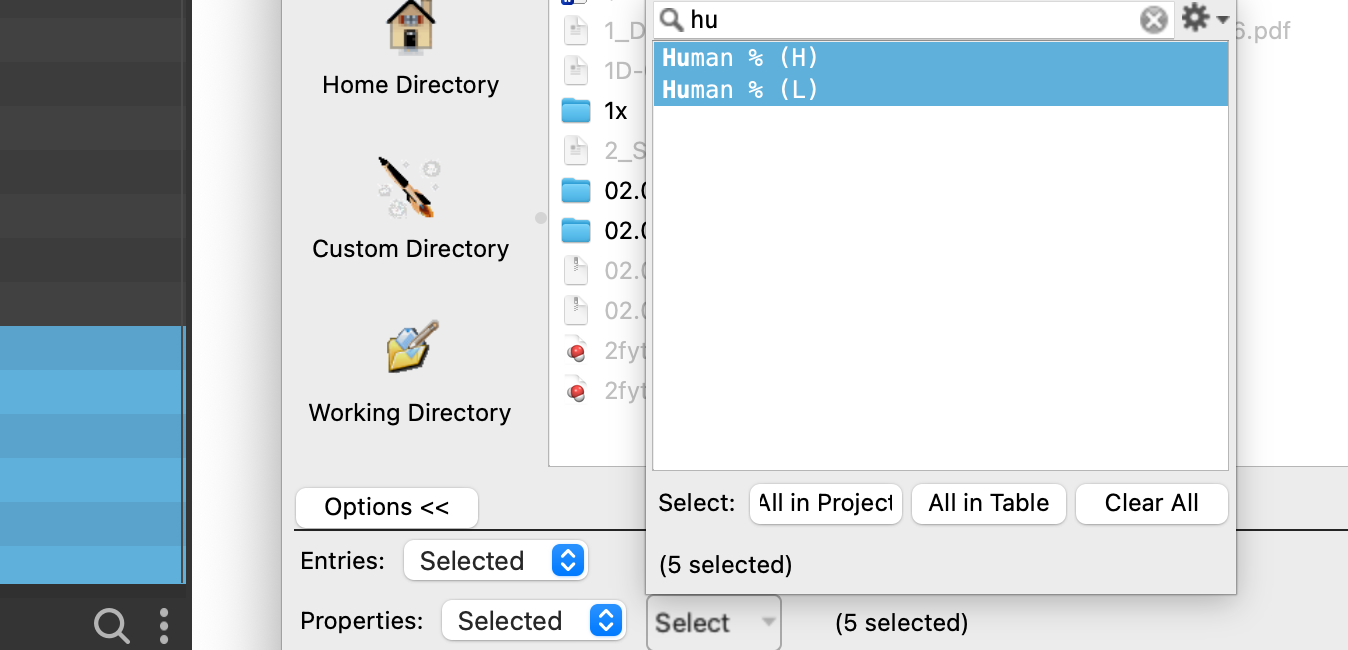
添加图片注释,不超过 140 字(可选)