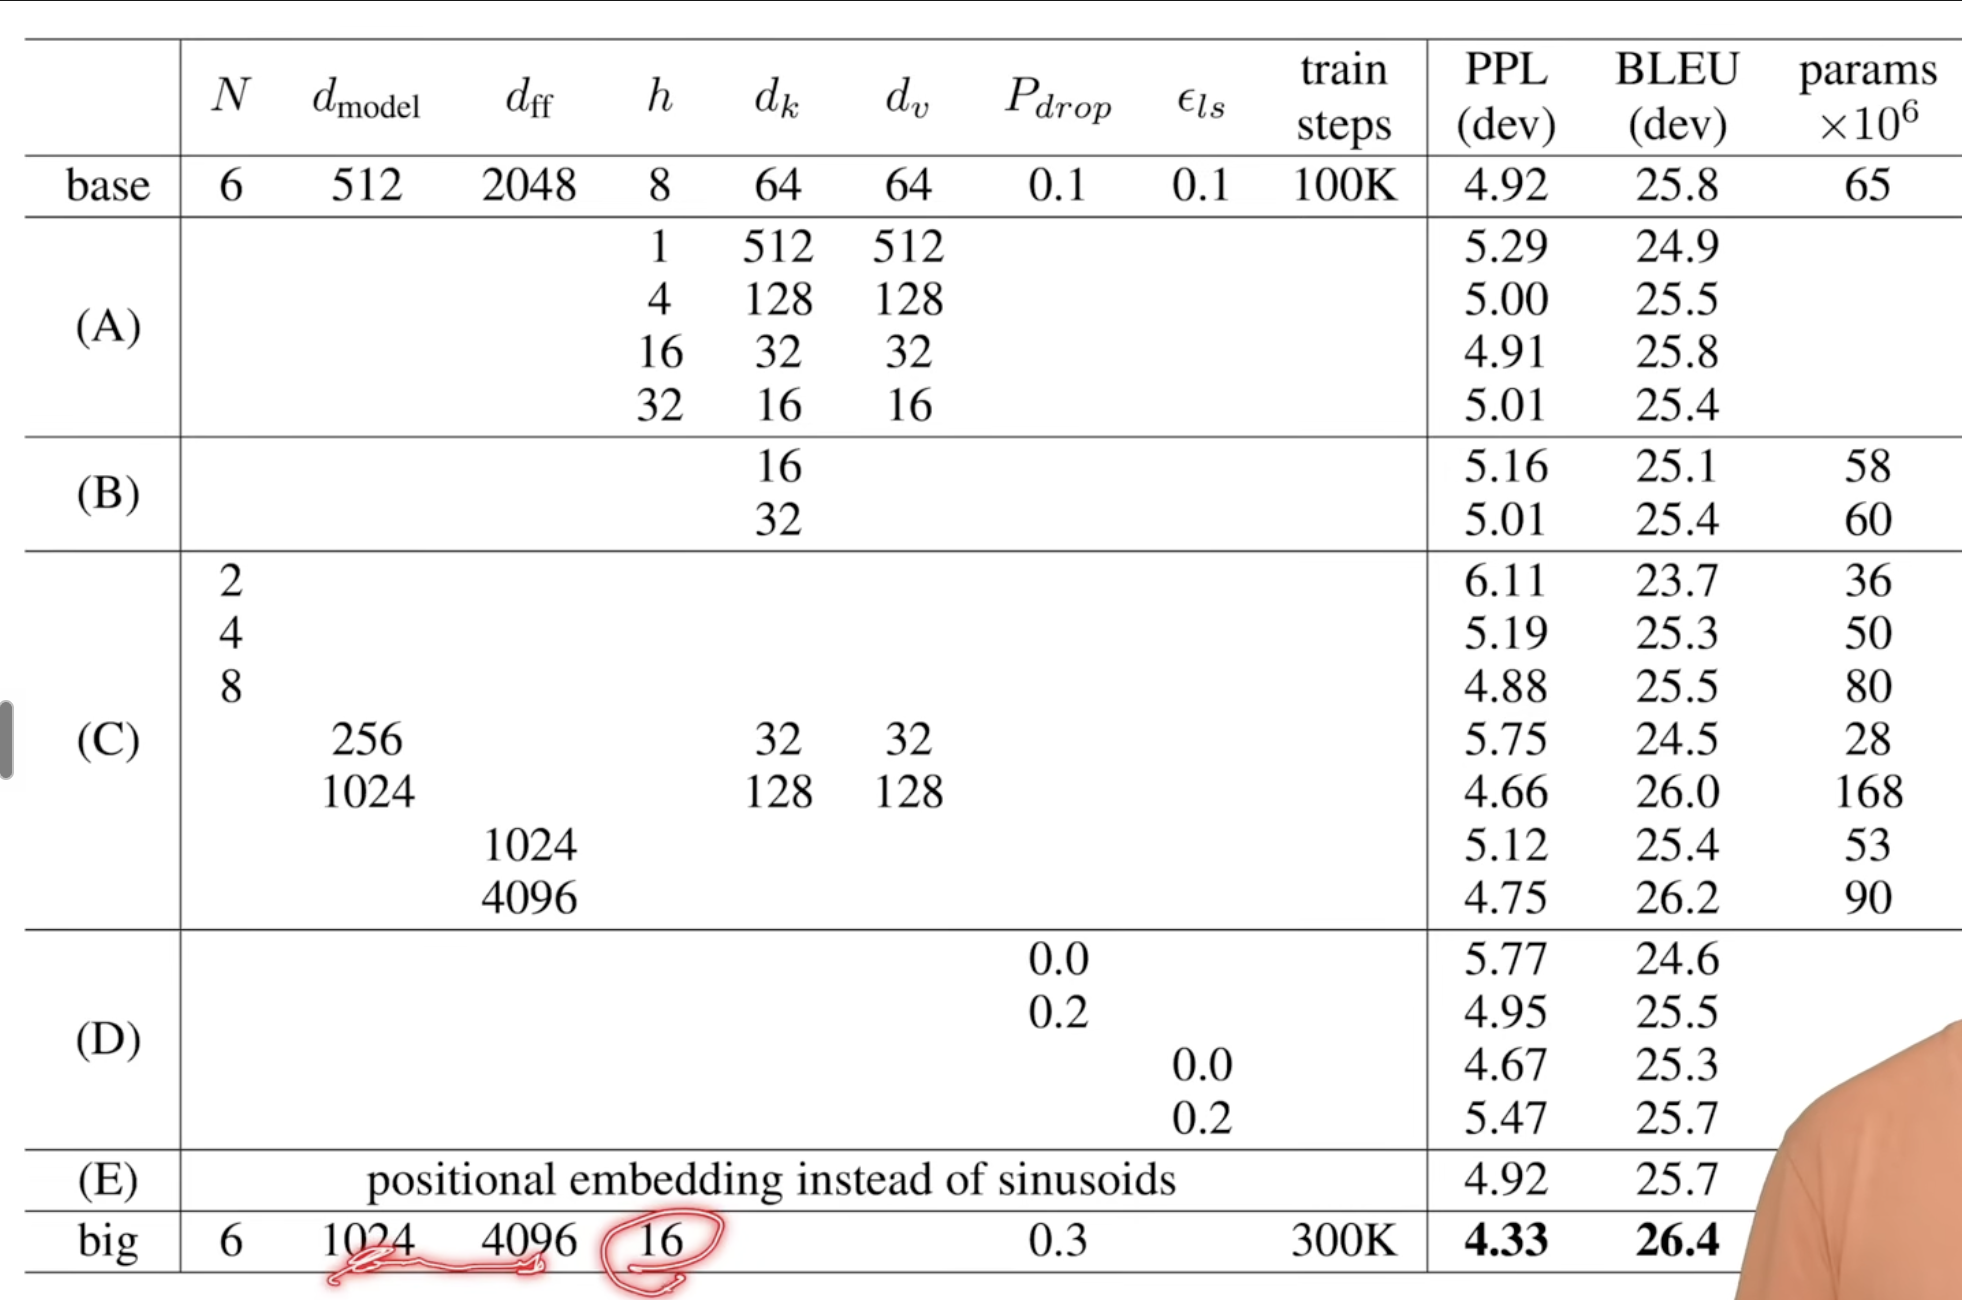
Reference: 李牧 Transformer论文精度
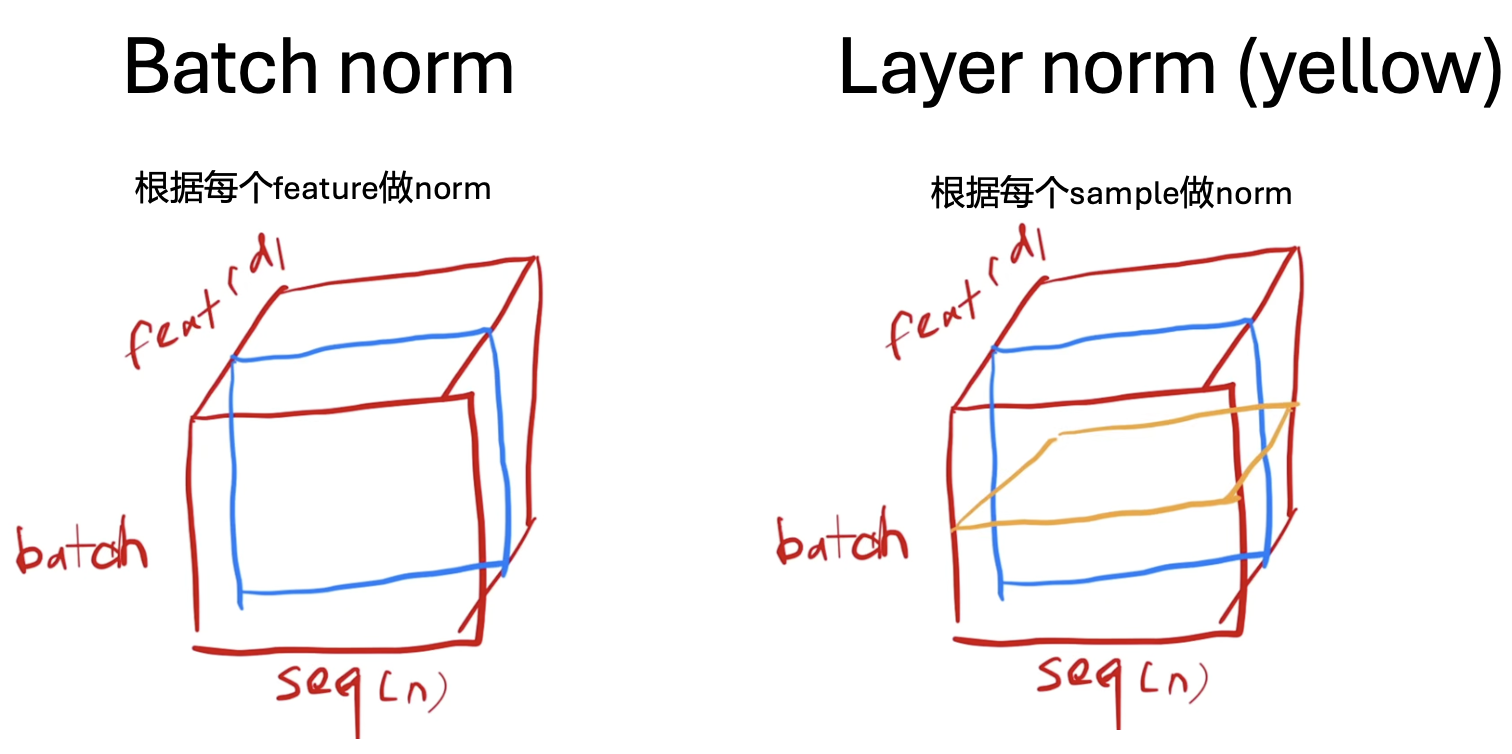
为什么喜欢用 layer norm 而不是 batch norm 呢?如果 sequence 有很长的或者很短的,那么 batch norm 它里面就会有很多的空白。
但如果是 layer norm 的话,它就会根据每个 sample 的长短,根据这个 sample 来做 norm。 不管长短,每个样本自己里面得到均值和方差。
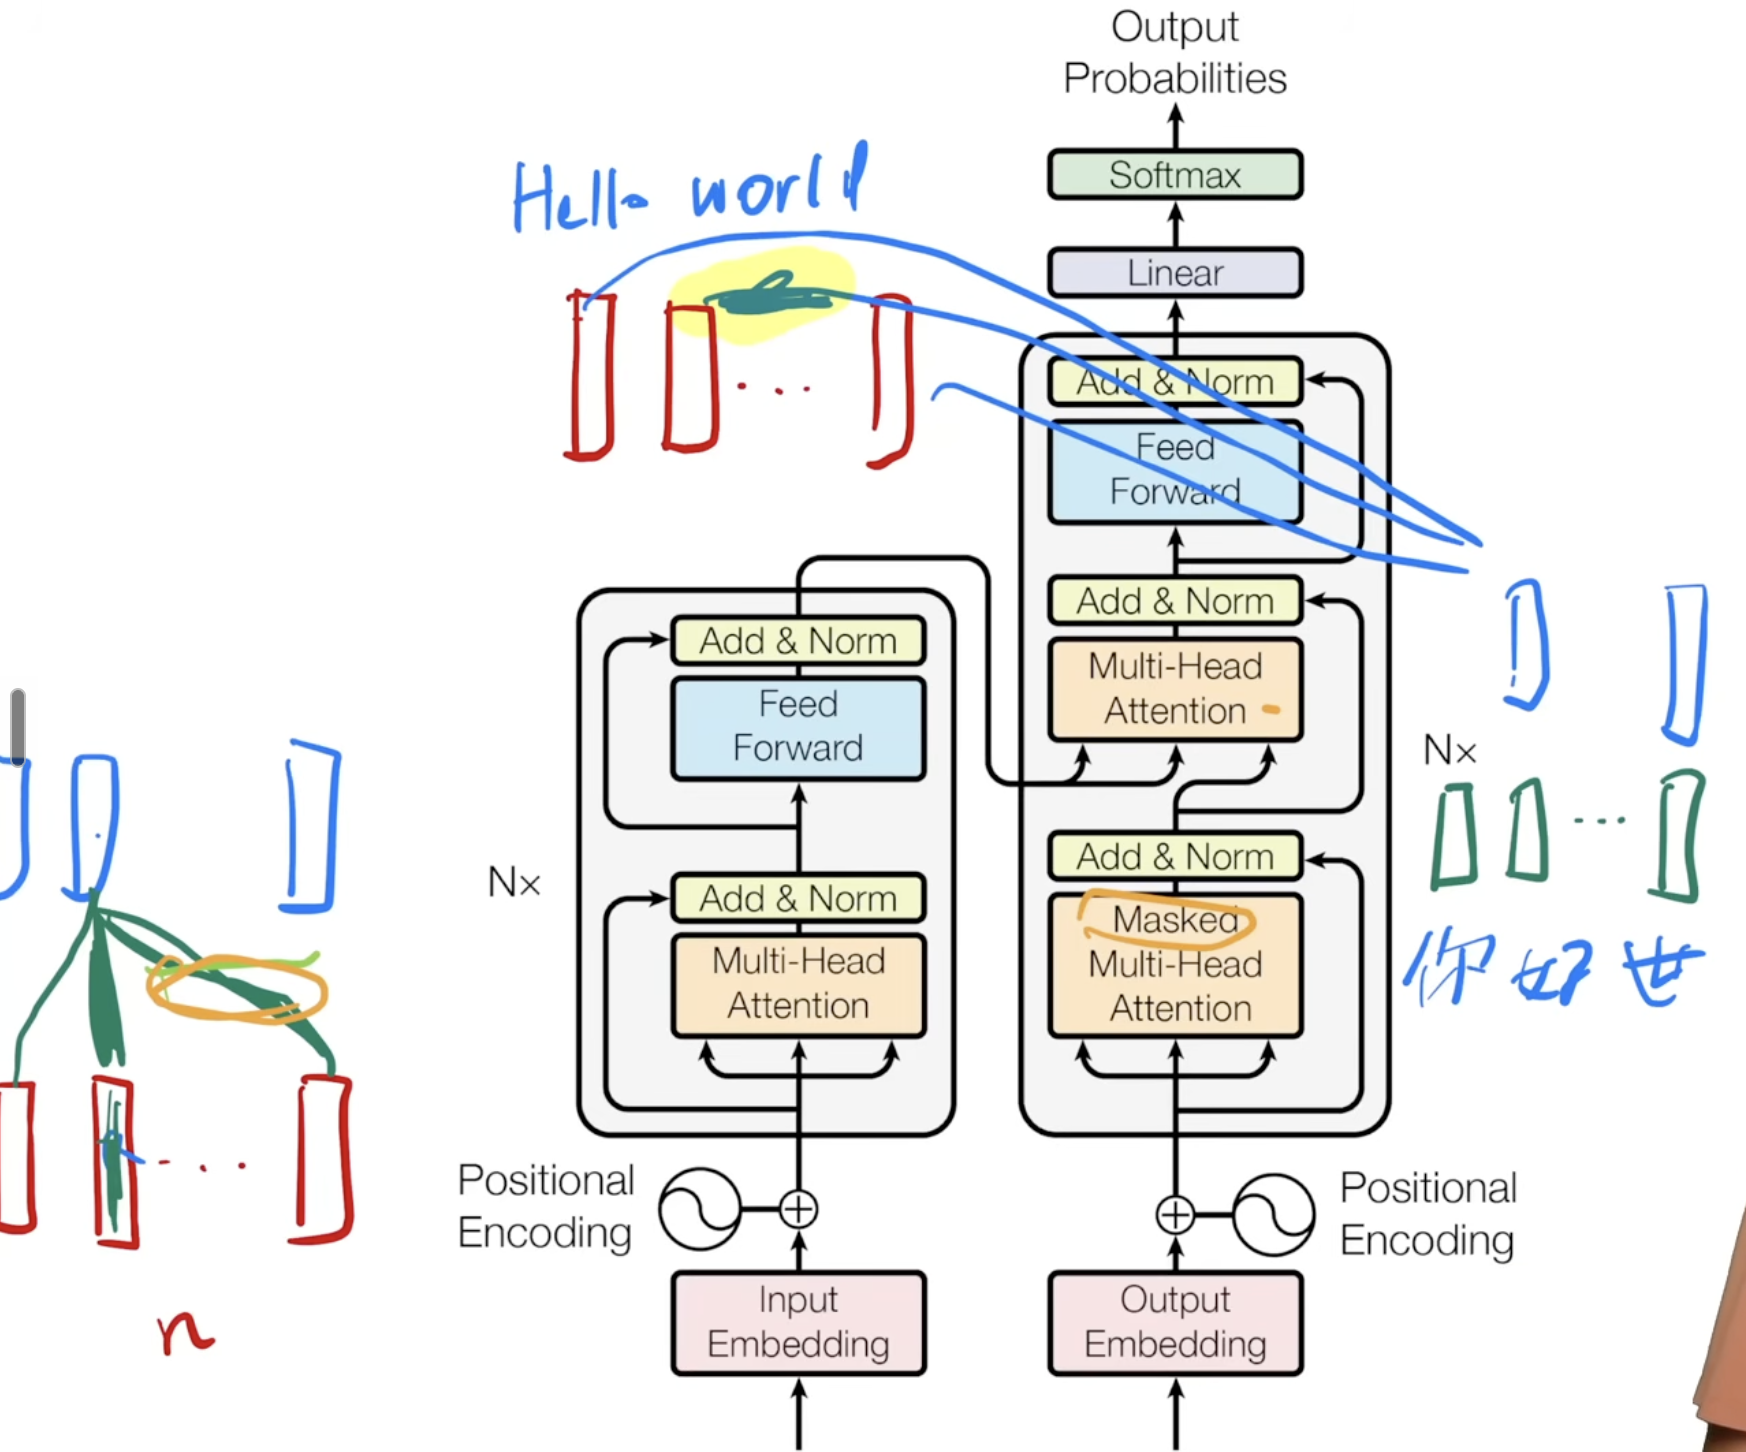
Mask
mask 的话就是会在一个句子 padding 的那个部分,它会把 value 设置成,比如说 1e-10;那么 softmax 就会把这个很小的数几乎就convert为 0 了。
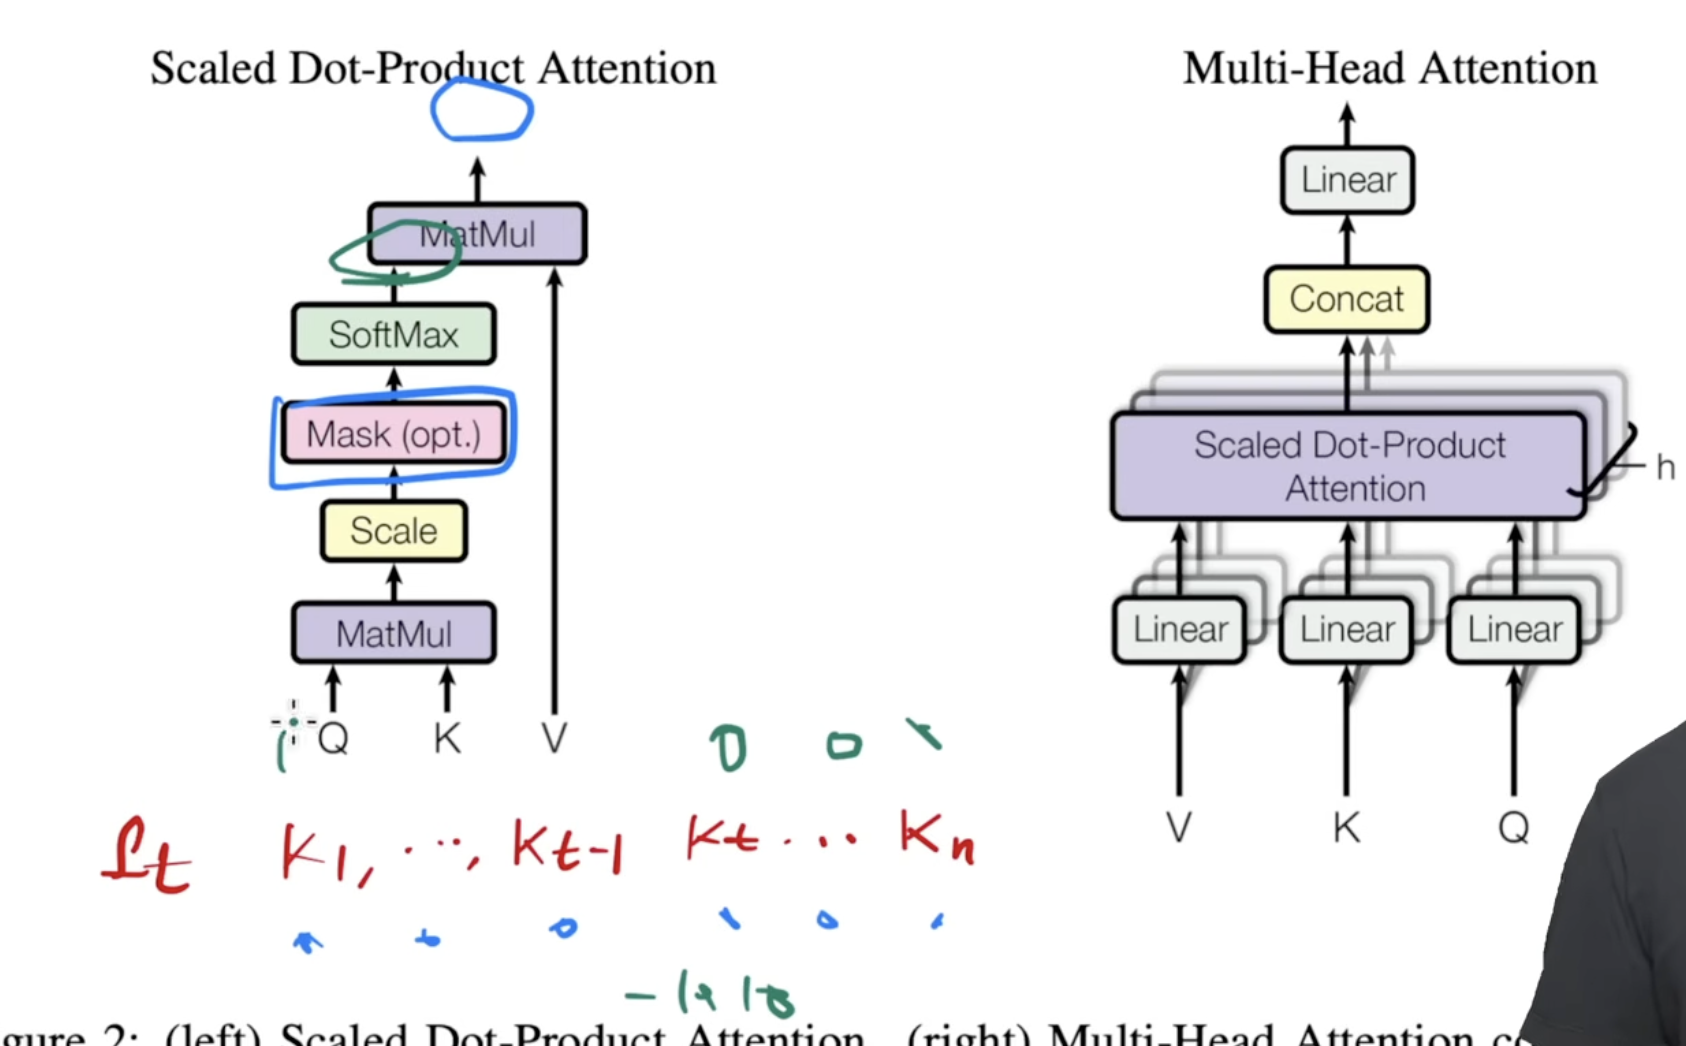
Multihead
Multi-head 就是图右侧的那个。每一个都做好多个左侧的运算,然后经过 attention 之后把这些东西 concatenate 起来。
左边encoder是self-attention。
n个长度的sequence,每个position上都有一个竖着的长条(红色)
蓝色是attention的输出。连接的线代表权重。这里是 self-attention。
每个词当然和自己的 dot production (cos similarity) 是最高的,所以他自己的权重是最高的。 然后如果右侧有一个词跟它也很像,那那个词也会有比较高的权重。
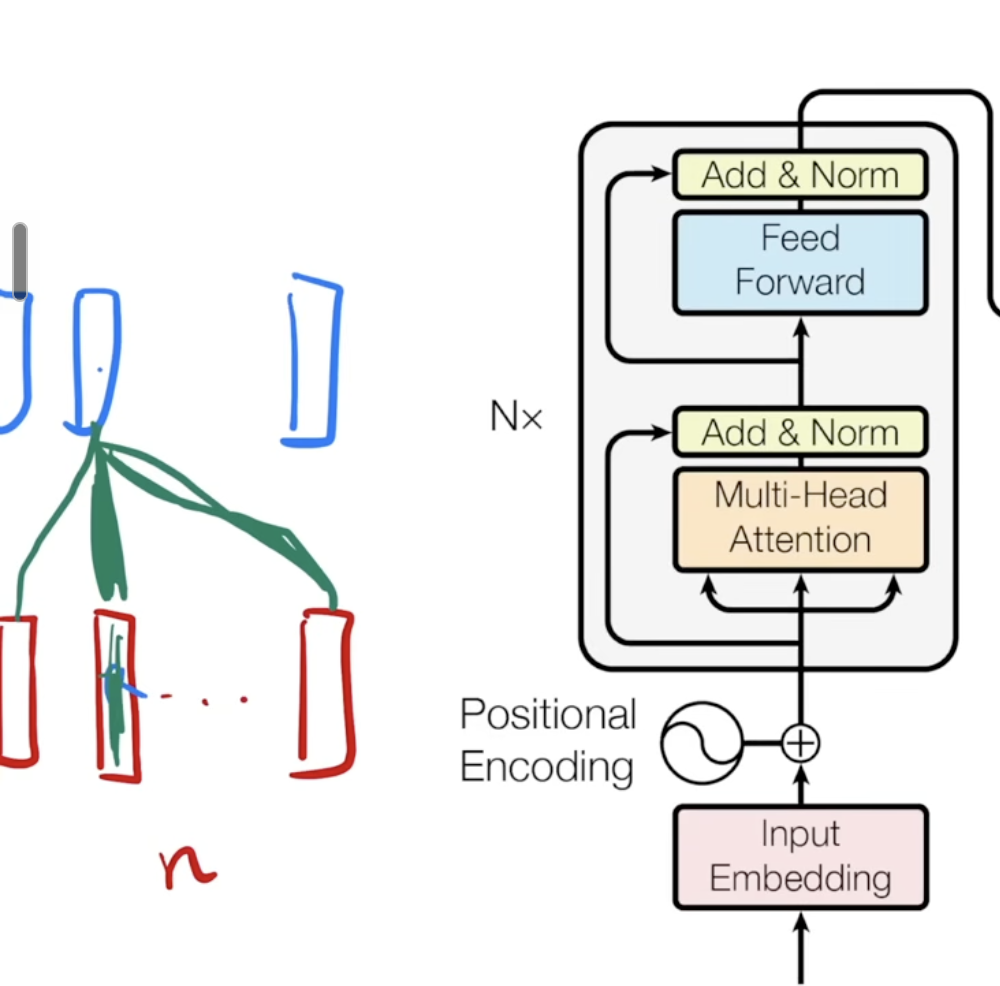
右侧的解码器上面的那个 multi-head attention,它其实是 cross-attention。
Decoder输入 那个箭头其实是 query。 然后左侧两个箭头其实是 key 和 value。 本质上就是解码器会有一些词,然后这个 query 它会去找左侧编码器encoder的它感兴趣的那个 key。
如果 encoder 每个 position 后面的这个 latent space 和 decoder 输入进去的每个 position 的 latent space 比较像,那它的权重就会多一些。
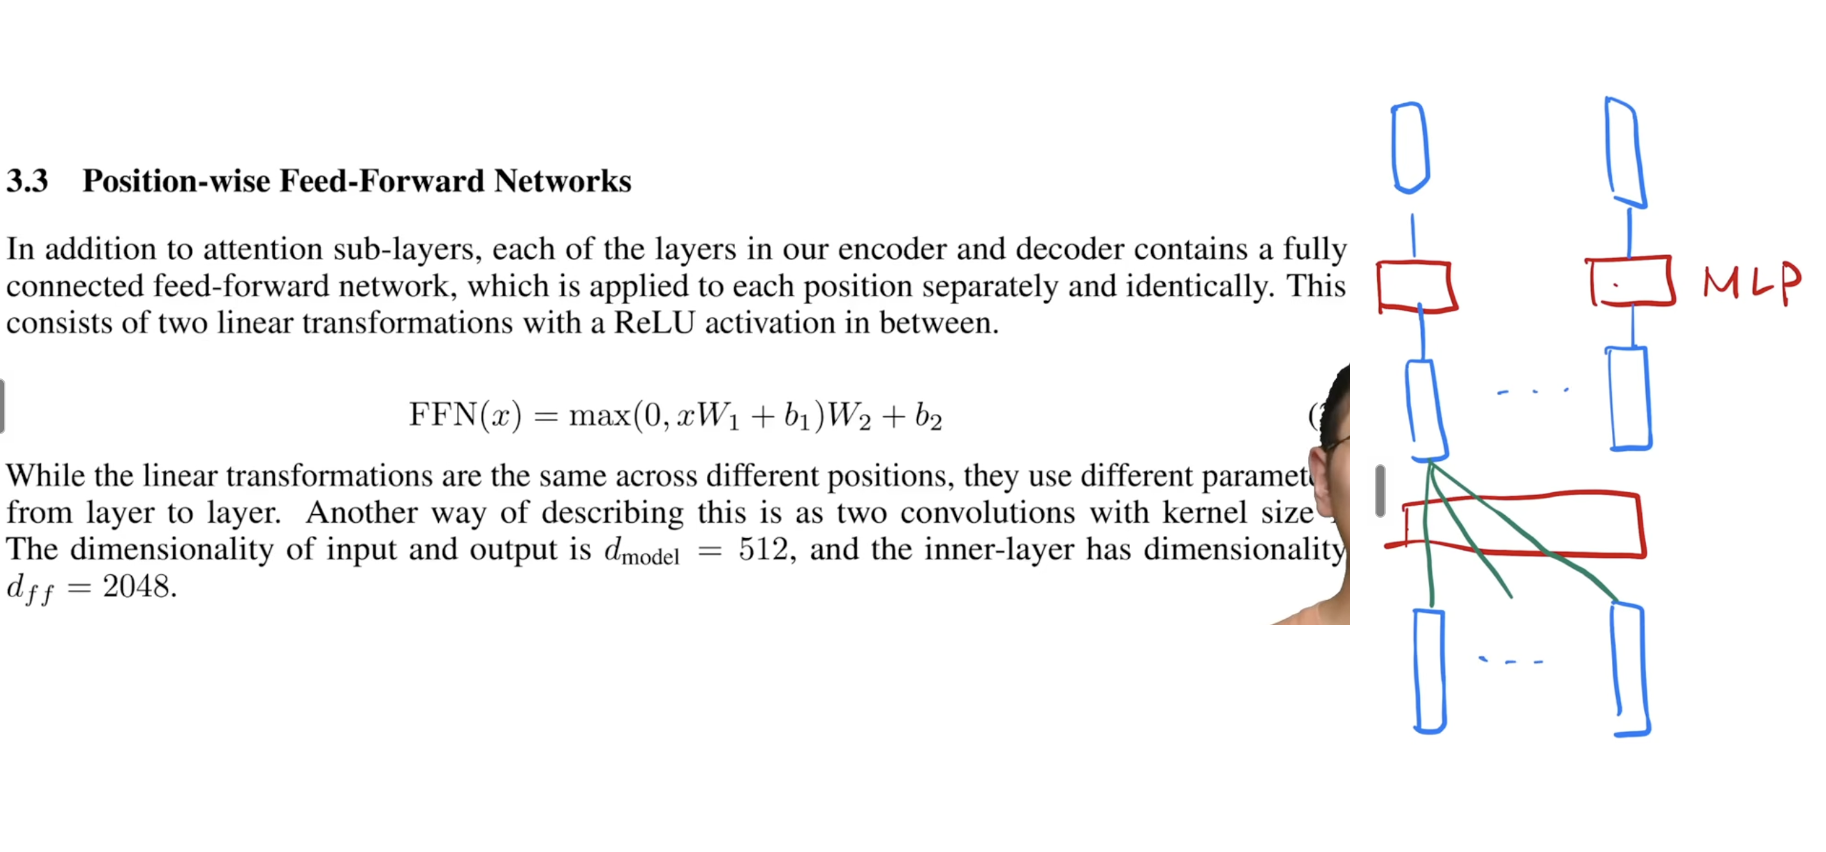
Feed forward
Feed-Forward 呢,它其实是 MLP。它会先从原来的 512 的 dimension 扩大 4 倍到 2048,之后经历一个 ReLU,后面再从 2048 缩回到 512。
所以公式里的话,它其实就是MLP–>RELU–>MLP
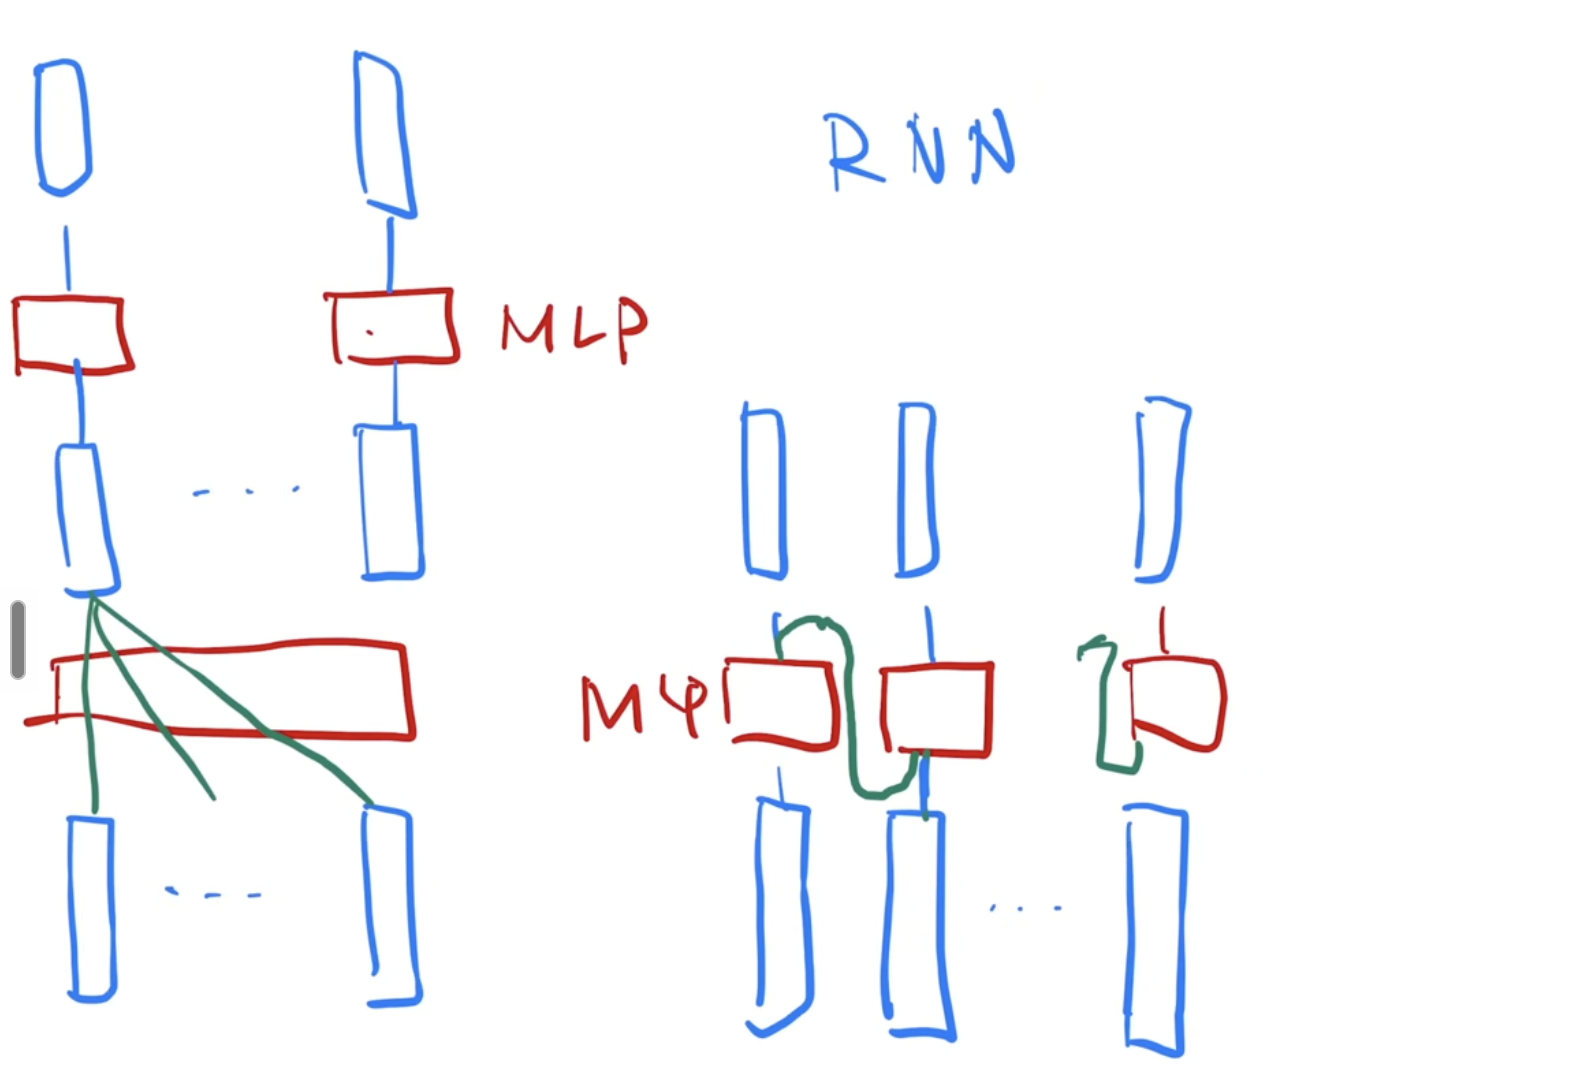
注意,它是对每个position 的 latent space 做 MLP (右侧的图 )。 就是因为那些每个词之间的关系,其实在 attention 里面它已经获得了那些信息了,所以 MLP 的话不需要每个 position or 词和词之间再相连了。
和RNN的区别 , 可以看到 RNN 的 MLP 是不断在更新的。
Training
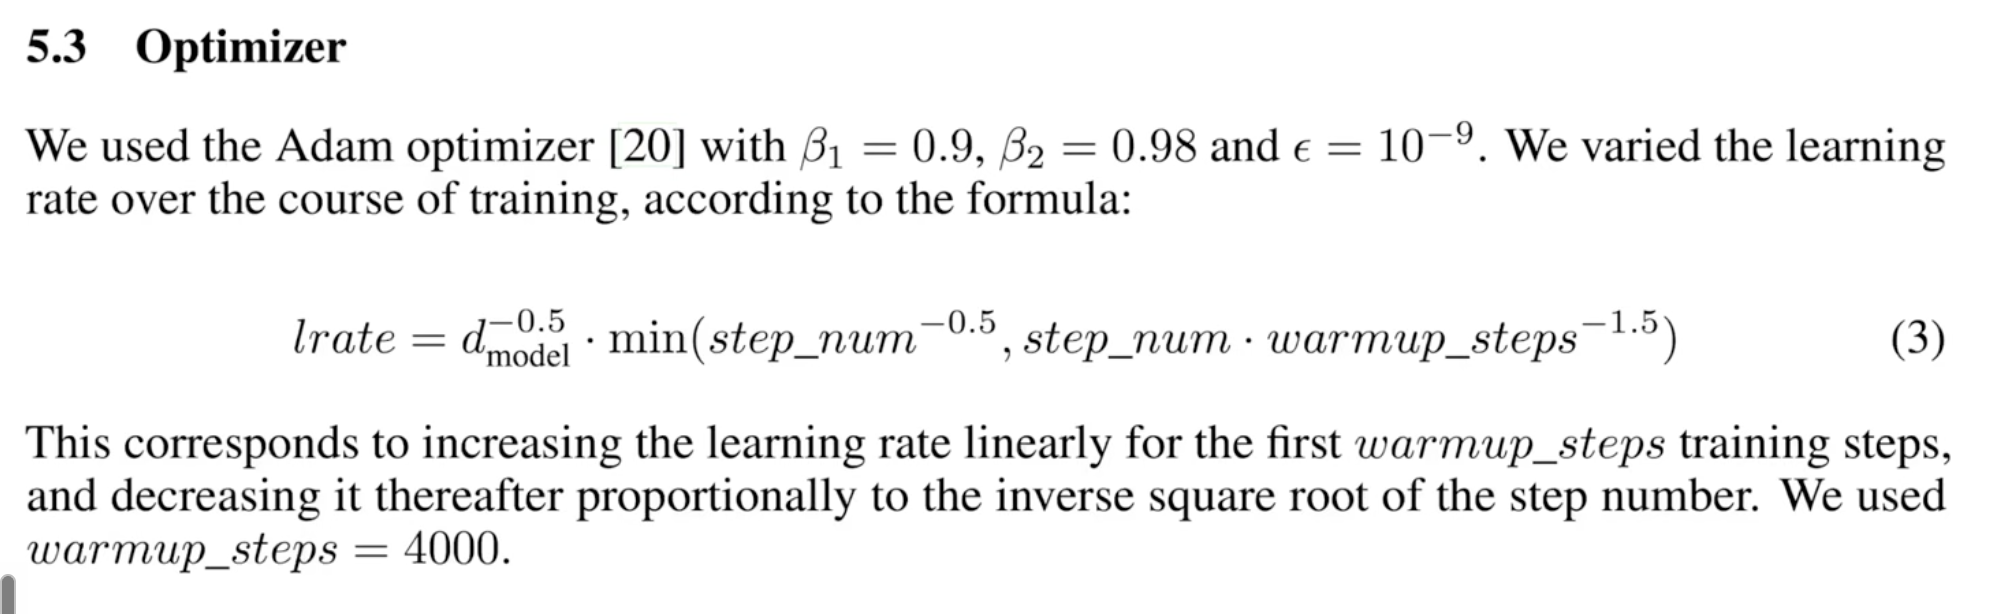
Optimizer
Optimizer 用的就是 Adam。 然后 learning rate 是根据那个 formula 先 warm up 上升,然后再根据 step number 慢慢下降。
Regularization
- label smoothing
用了 label smoothing = 0.1,因为 softmax 无法特别逼近 1,所以 0.9 就可以。 这个会 hurt perplexity,就是会增加一些不确定性,但是可以让这个模型在准确度上更好。

- dropout
用了0.1。Apply 到了 Attention 还有 MLP 里,还用进了 embeddings 和 position embeddings 里。
参数
N是堆了多少层。
d_model 是有每个 position 后面latent space 的 dimension number。
d_ff 是 Feed-Forward 的层数,就是之前说的 4 倍。
h 是 Multi-Head 里面的 head 数。
d_k、d_v 都是 KV 的linear dimension。
可以注意到 head * dk 应该等于 d_model,就是 latent space 的 dimension。
P-drop 是 drop out。 Epsilon ls 就是 label smoothing。