t-test & p value
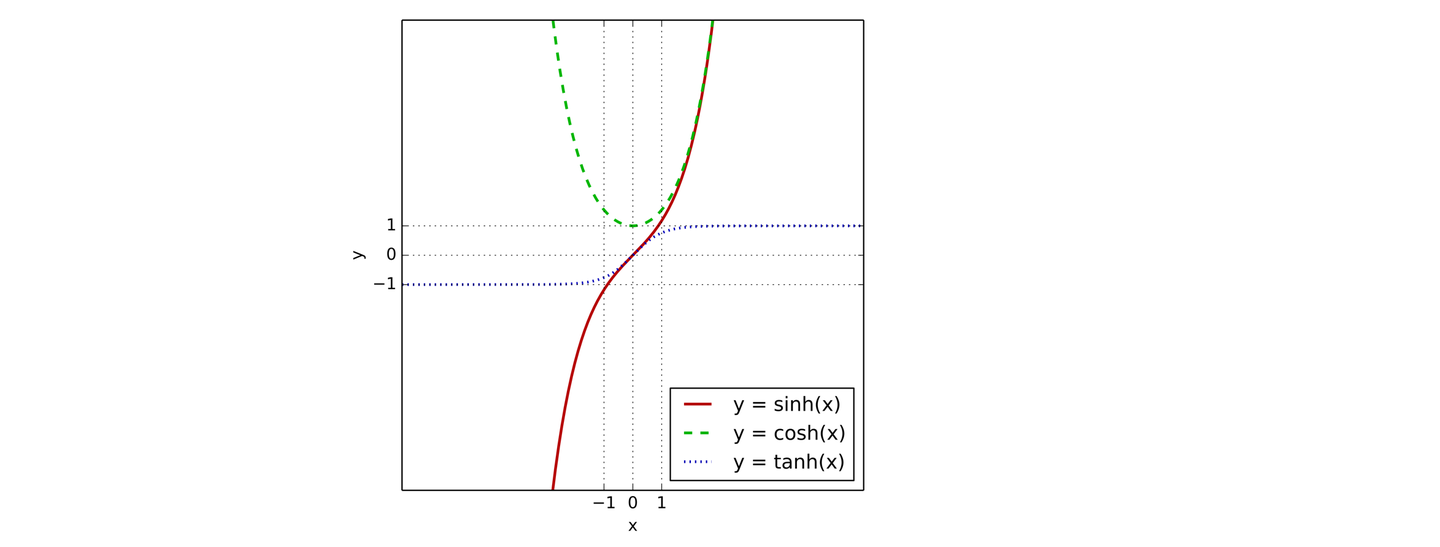
tanh
h,herperbolic, hyperbola双曲线的意思。双曲线就是平面上到两个定点的距离差的绝对值是一个常数的点的轨迹。
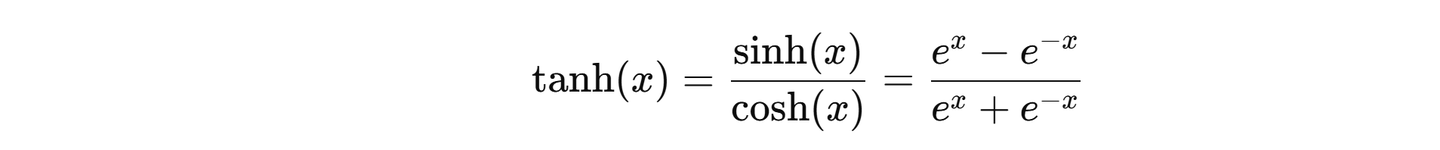
添加图片注释,不超过 140 字(可选)
添加图片注释,不超过 140 字(可选)
FC + p value
可以把FC和pvalue 合在一起

添加图片注释,不超过 140 字(可选)
可以在log2FC前加一个tanh,使得它的值在-1和1之间,log2FC=1就是FC是2(两倍),反之是0.5(一半)。
这样可以防止极端的FC值,同时加大p值的权重。
但注意8倍FC和2FC的区别会变得很小,会失去resolution,有一个解决办法就是在(log2FC)加一个scaling factor。
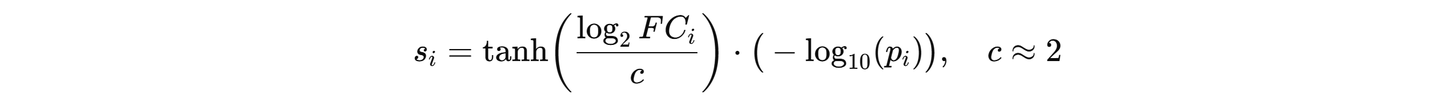
添加图片注释,不超过 140 字(可选)
这样FC在0.25和4之间了就比较敏感了。
Standard error
和标准差不同,standard error (标准误)会再除以样本数量(sample number)的平方根。
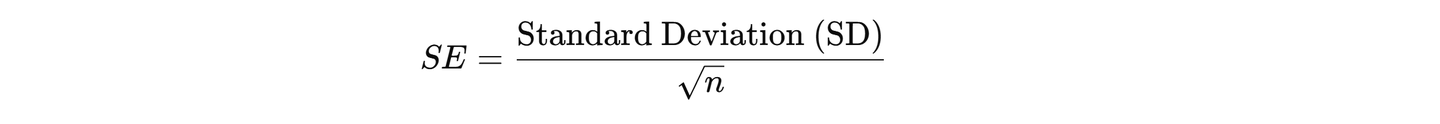
添加图片注释,不超过 140 字(可选)
Sample vs Population
population 总体,是研究对象的完整集合。比如一个城市里的所有居民。他们的收入有总体均值μ,和总体标准差σ,总体数量N。
sample 样本。由于现实原因,无法测量整体的时候,取一些样本,比如随机抽取一千名市民看他们的收入。样本平均值是x̄,样本标准差是s,样本数量n。
样本里很多时候不知道总体μ,就会假设一个μ₀。
t-test
利用 t 值和 t 分布来判断是否拒绝原有假设的方法。
t value 计算
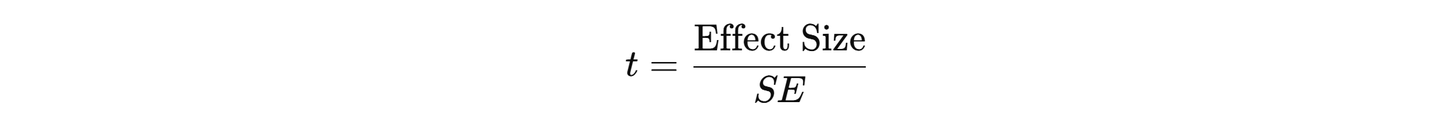
添加图片注释,不超过 140 字(可选)
也就是:
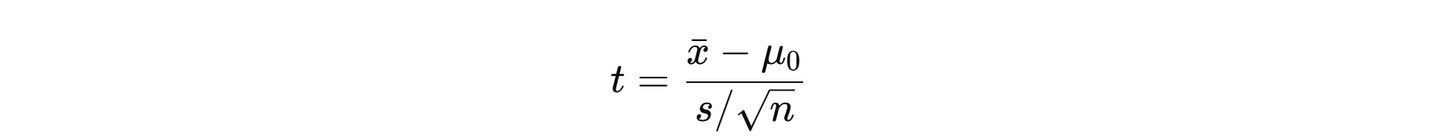
添加图片注释,不超过 140 字(可选)
μ₀ 是总样本均值的假设。
t值相当于是相对于总体均值的位置。
负数,说明样本均值比总体均值 小。反之。
p-value
当sample数量多的时候,假设t值会落在标准正态N(0,1) 的分布中。然后看它的位置在CDF的哪里。
from scipy.stats import norm
# 如果t是正的
onetail = 1-norm.cdf(t) # 右尾
# 如果t是负值
onetail = norm.cdf(t) # 左尾

# 分布是对称的时候
twotail = 2*onetail # two tail
当sample数量少的时候,假设t值落在t分布中,看它的位置在哪里。
from scipy.stats import t
t.cdf(tvalue,df=20) # 假设df是20
Adjusted p
Benjamini–Hochberg (BH),也叫FDR, false discovery rate。
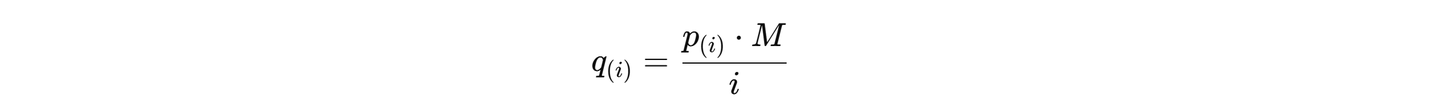
添加图片注释,不超过 140 字(可选)
M是值的数量,i是p的排序rank。
CDF
累积分布函数(CDF),不依赖于分布形态(不一定来自于正态分布,任何分布都可以)。
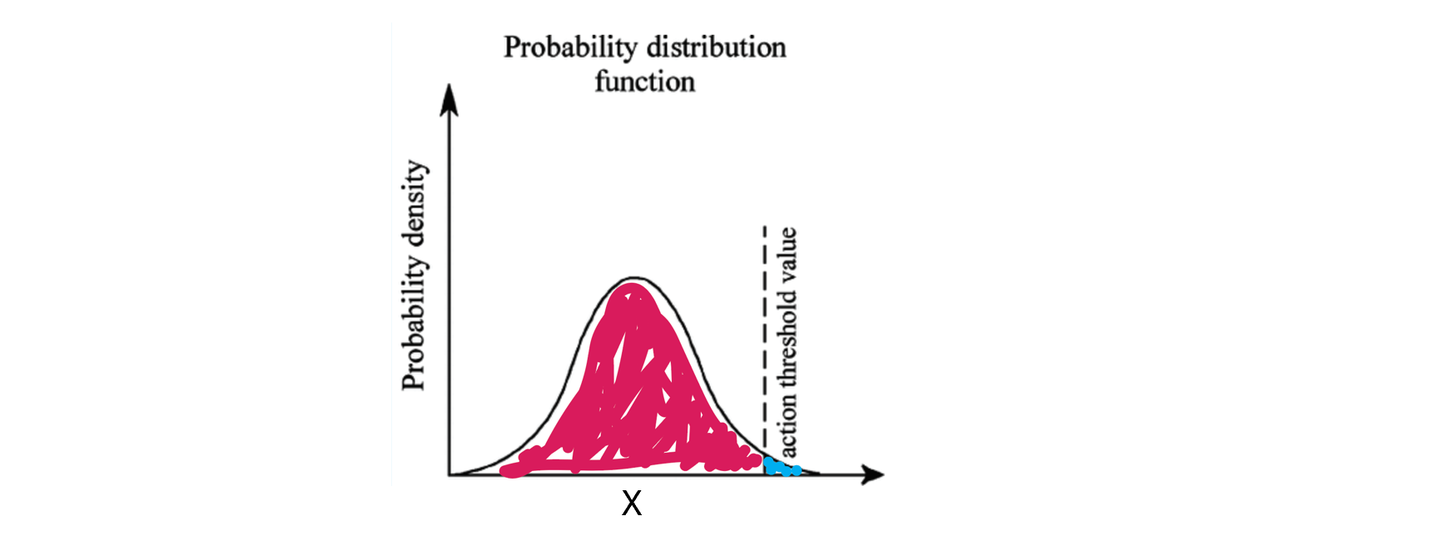
可以把 PDF 想成histogram的平滑版本,value distribution, 每个x对应的值,类似于count,但不是概率。
然后CDF是PDF里面积的函数,把histogram从左到右累加起来。面积加满,总概率就是 1。
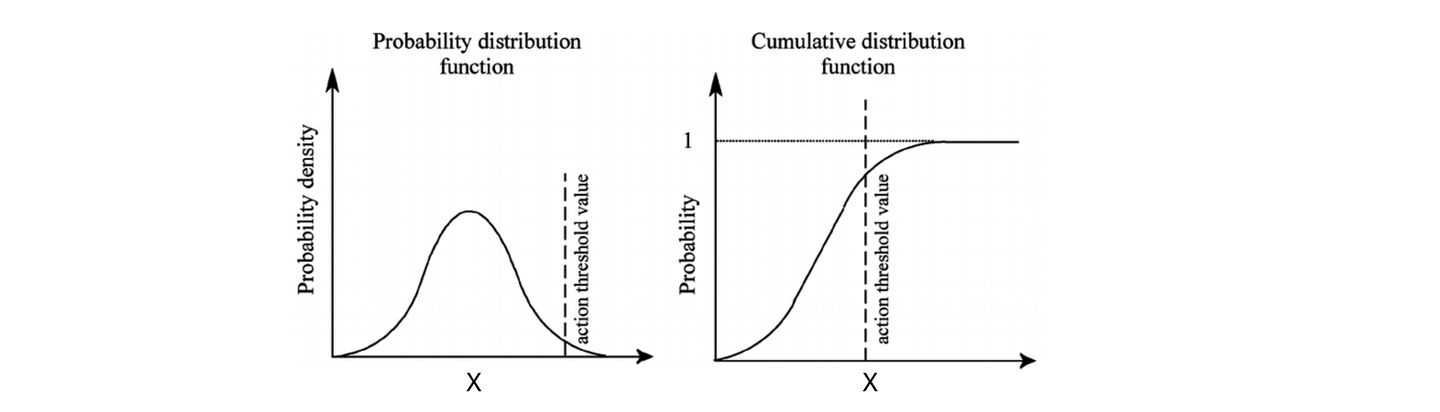
添加图片注释,不超过 140 字(可选)
那么CDF里x对应的值,相当于PDF里红色除以全部面积的值。
添加图片注释,不超过 140 字(可选)
scipy
假设t在standard norm 标准正态分布下
from scipy.stats import norm

prob = norm.cdf(1.96) # norm的default是μ为0,σ为1
也可以改norm里的参数,比如设置均值为100,sigma为15
# N(μ=100, σ=15)
dist = norm(loc=100, scale=15)

print(dist.cdf(130))   # P(X <= 130)
print(dist.pdf(100))   # f(100)
Normal distribution
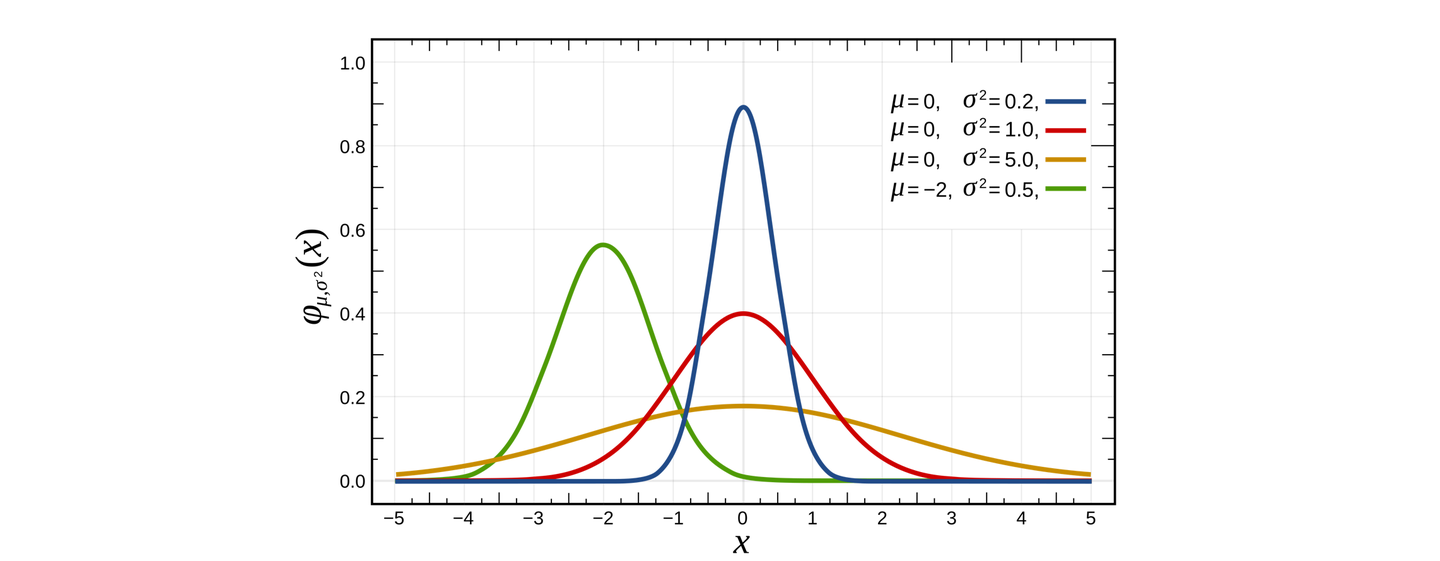
也叫高斯分布。
添加图片注释,不超过 140 字(可选)
Standard normal distribution
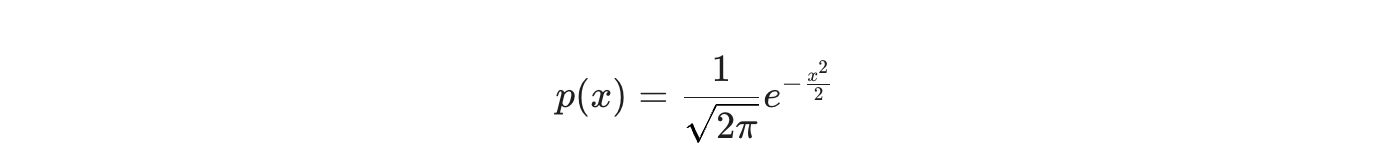
添加图片注释,不超过 140 字(可选)
N(0,1) ,均值为0,标准差和方差为1。上图中红色的线。
from scipy.stats import norm
prob = norm.cdf(1.96)
t distribution
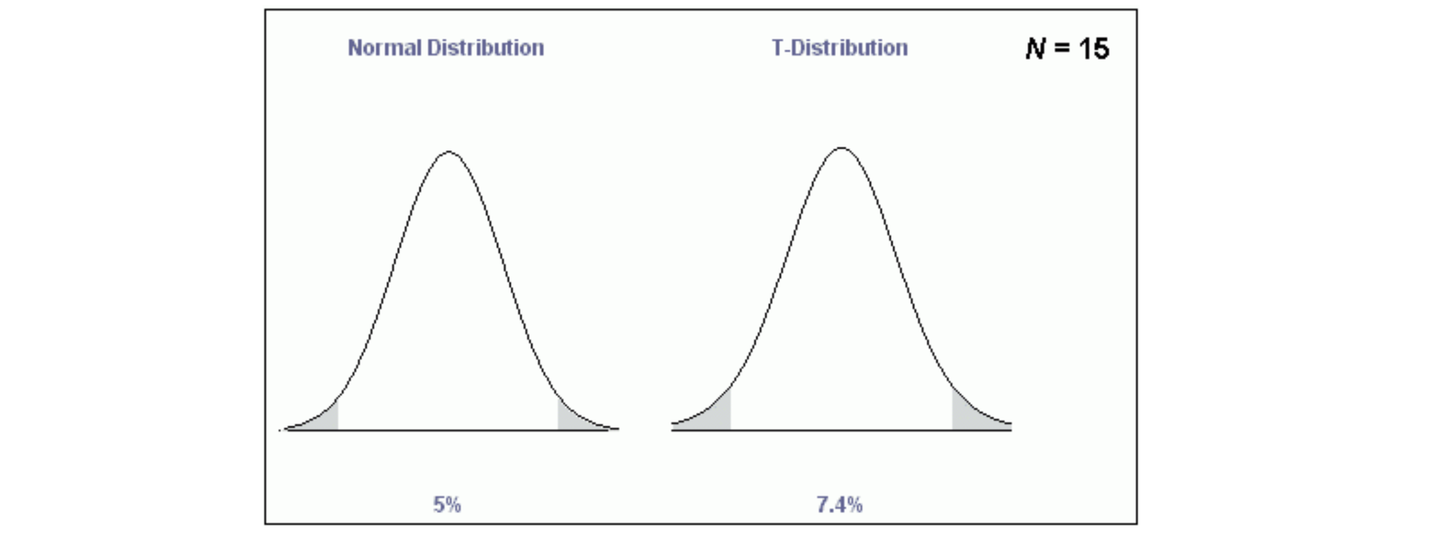
尾巴更宽的分布,样本数量少的时候(<30),t-distribution更适合用来计算p值。
添加图片注释,不超过 140 字(可选)
参数degrees of freedom (df), 公式里写作ν
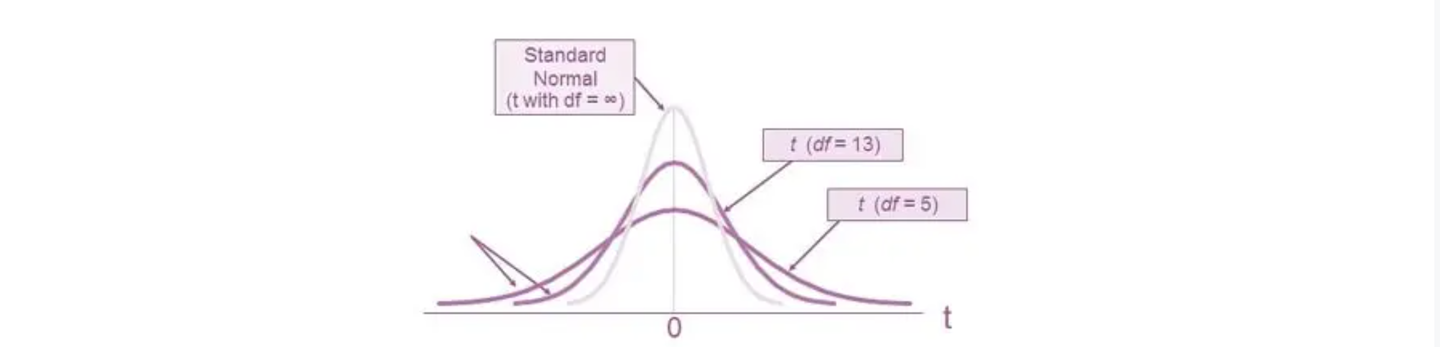
添加图片注释,不超过 140 字(可选)
Central limit theorem
CLT。根据中心极限定理,在大样本条件下许多测验可以被贴合为正态分布。
在许多情况下,对于独立并同样分布的随机变量,即使原始变量本身不是正态分布,normalized 的sample值,符合standard normal distribution。
PAGE
Parametric Analysis of Gene Set Enrichment, Kim & Volsky 2005
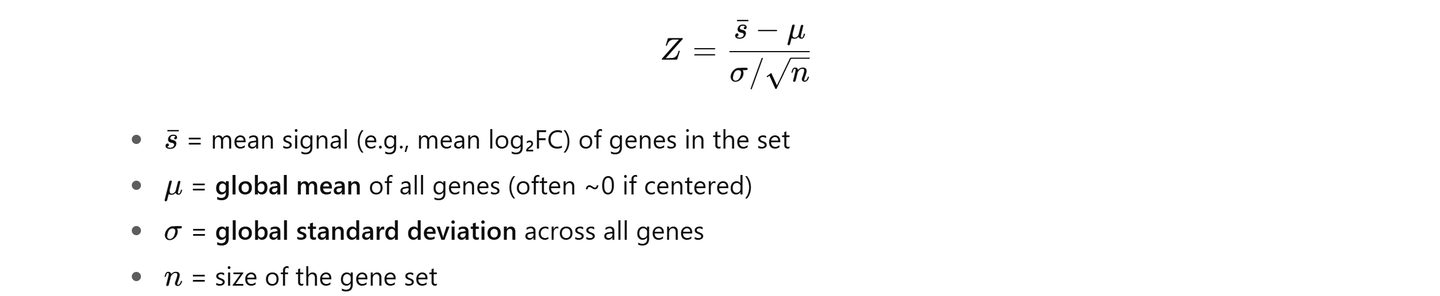
添加图片注释,不超过 140 字(可选)
Z就是enrichment值,后面的p value 根据standard norm distribution来算。
KSEA
kinase-substrate enrichment analysis. 用的PAGE方法计算
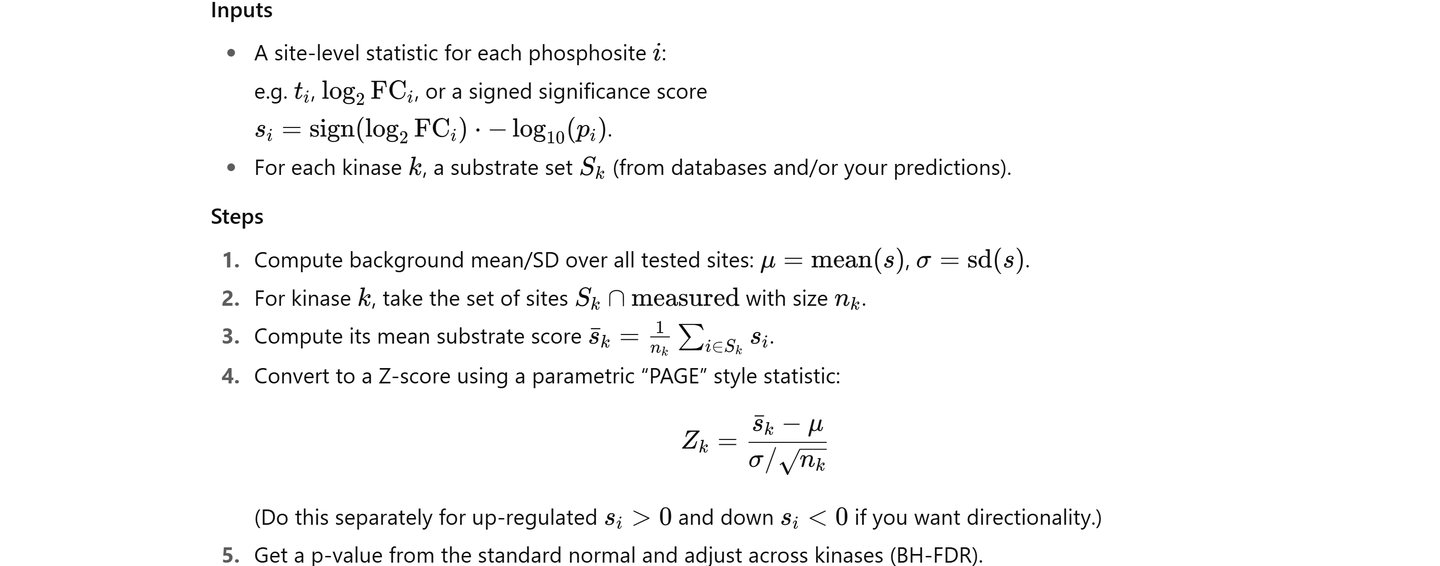
添加图片注释,不超过 140 字(可选)
PCA
Covariance matrix 协方差矩阵
公式
注意先把X中心化,也就是减去每个特征各自的均值 (对每一列(特征)减去它自己的均值)
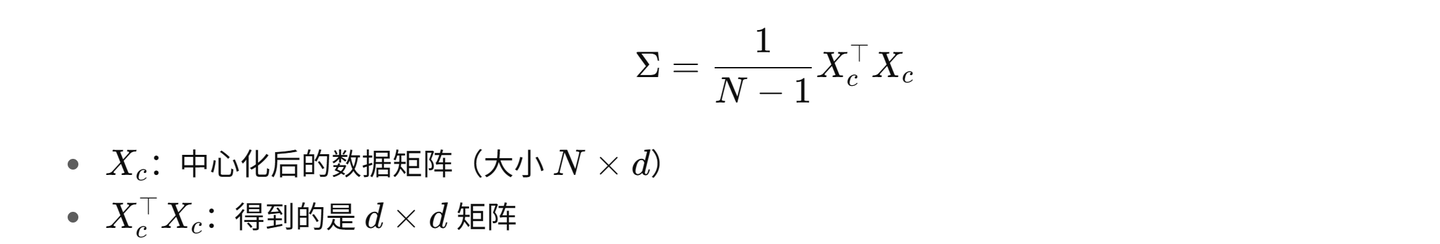
添加图片注释,不超过 140 字(可选)
矩阵:
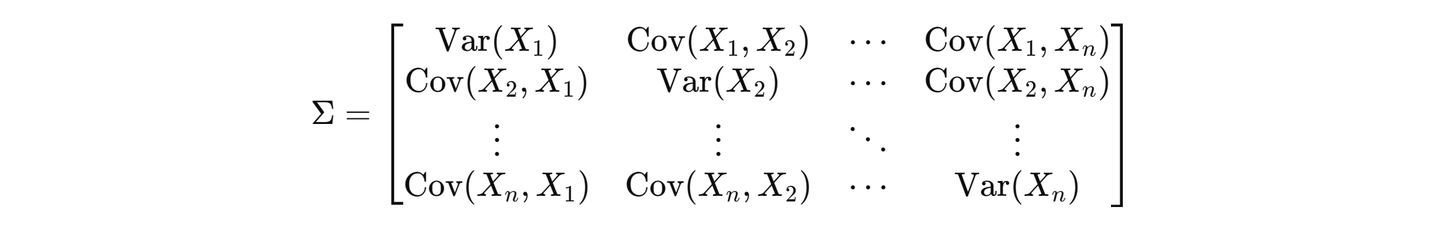
添加图片注释,不超过 140 字(可选)
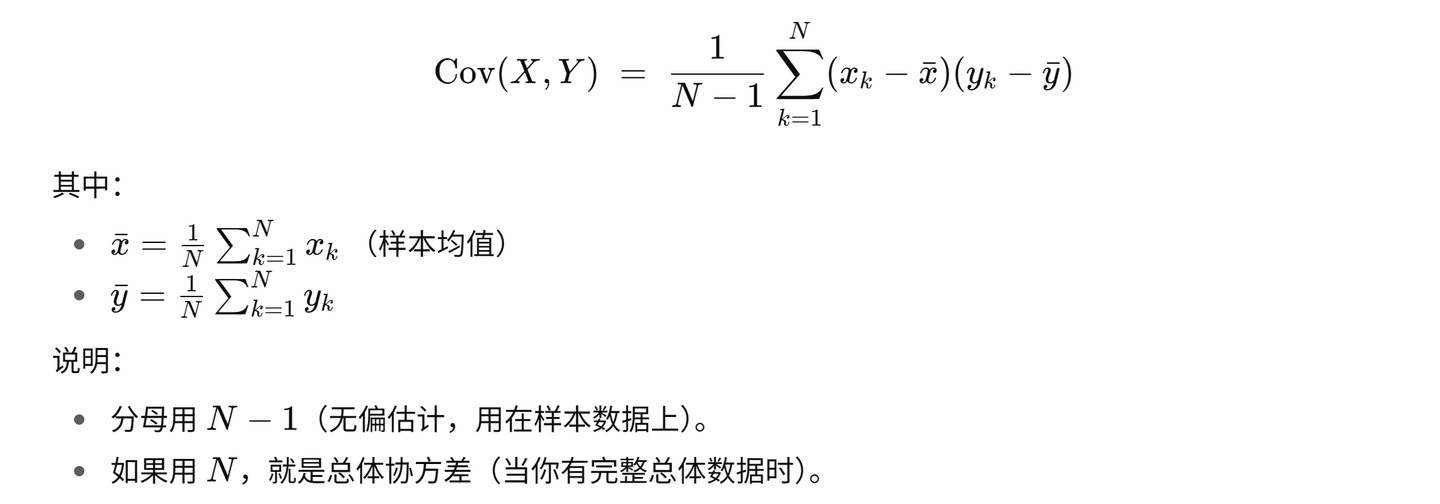
Covariance 协方差
covariance是自己和别的dot product再除以N-1
添加图片注释,不超过 140 字(可选)
Variance 方差
variance是vector自己和自己的dot product再除以N-1
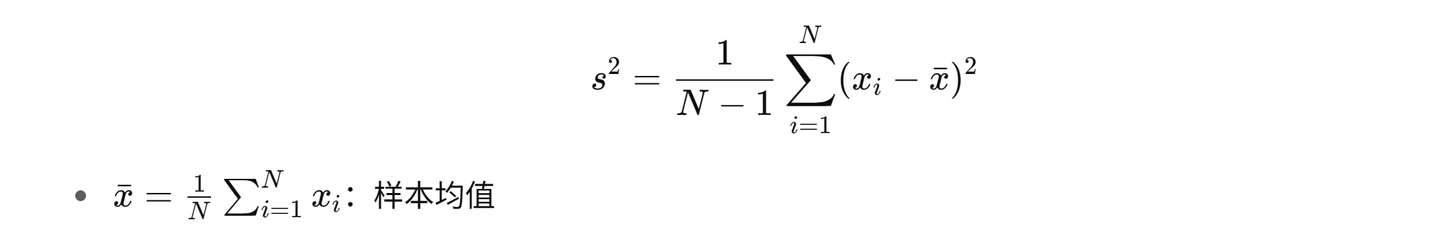
添加图片注释,不超过 140 字(可选)
这里N-1是sample variance样本方差,如果是总体方差population variance,那就是除以N
另一种population variance的写法:
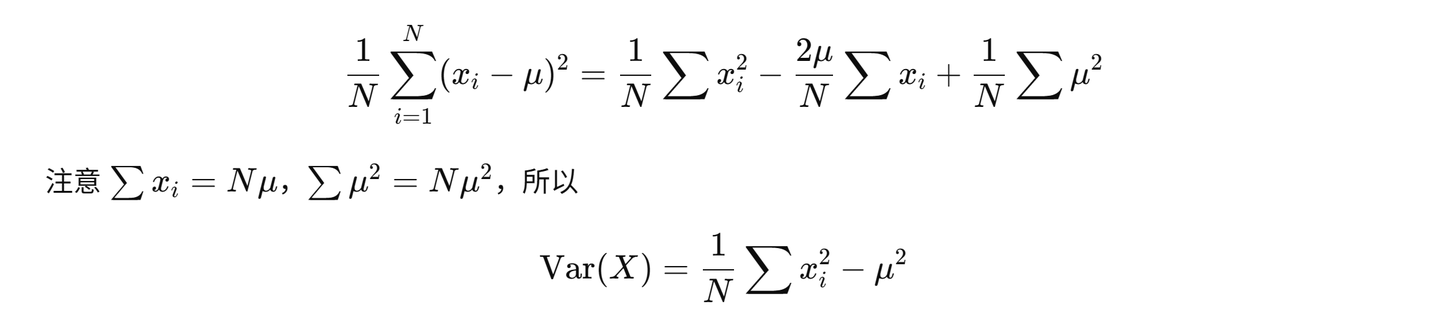
添加图片注释,不超过 140 字(可选)
如果用期望来写的话,可以写成
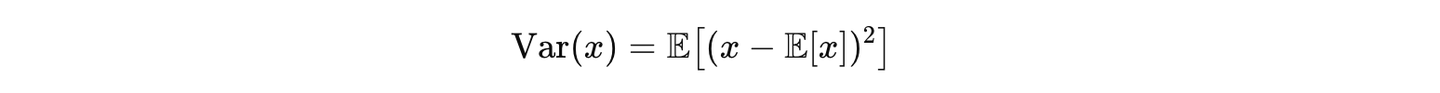
添加图片注释,不超过 140 字(可选)
N-1
无偏估计(unbiased estimator)
之所以N-1是因为样本不能反应整体,往往会低估variance,所以除以N-1
另外,如果只有一个样本点(N=1N=1N=1),那么 (x1−xˉ)(y1−yˉ)一定是 0。但显然总体的协方差不可能就是 0, 所以必须“修正”分母,才能让期望值正确。
Standard Deviation标准差
在var上加个根号
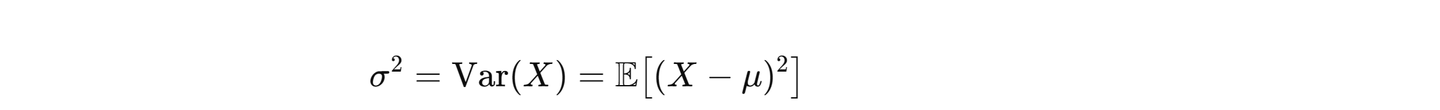
添加图片注释,不超过 140 字(可选)
E是期望,这里是平均值
Expectation 期望
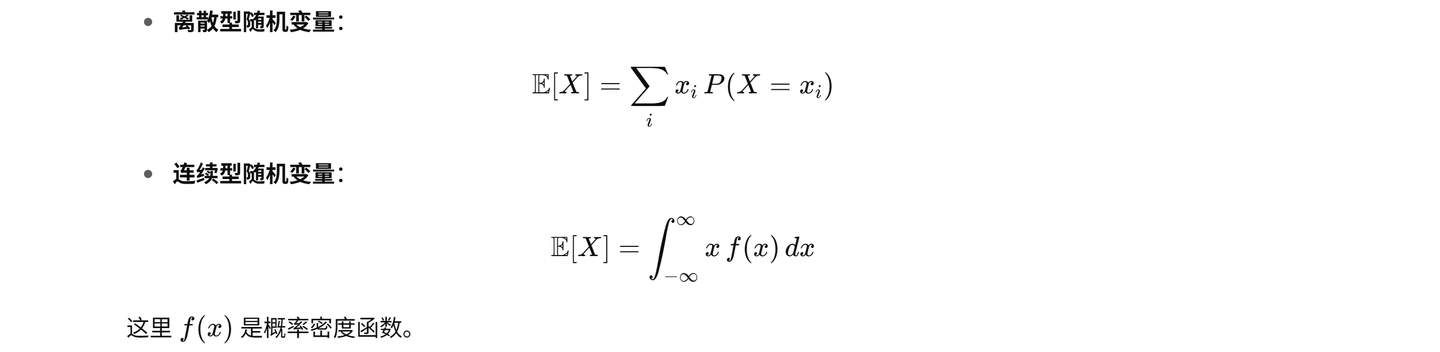
添加图片注释,不超过 140 字(可选)
如果每个概率相等,那就是均值
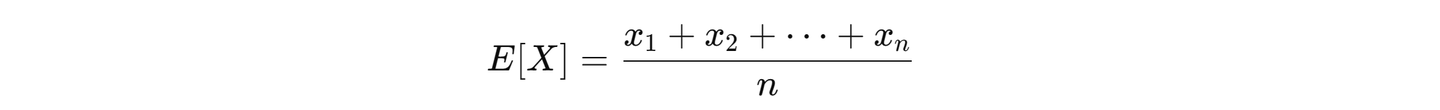
添加图片注释,不超过 140 字(可选)
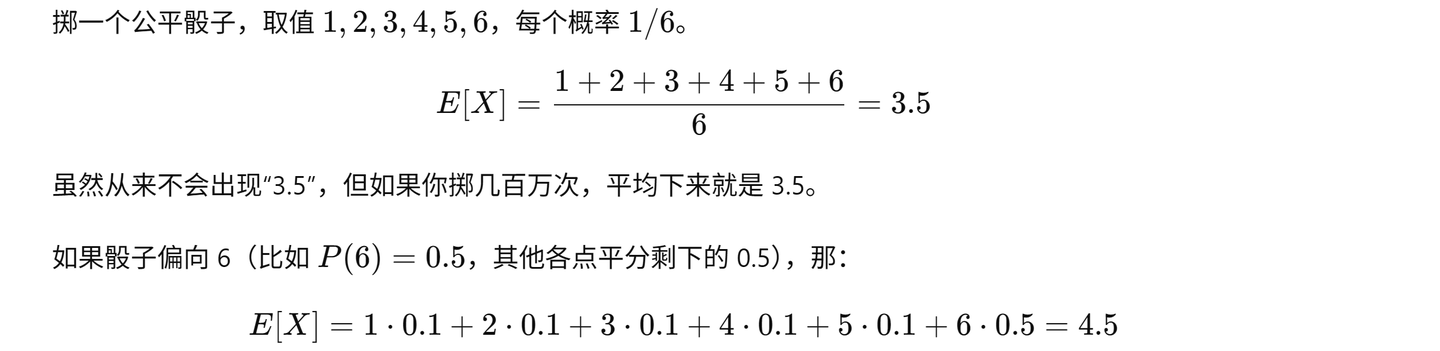
如果概率不一样,就是加权平均值
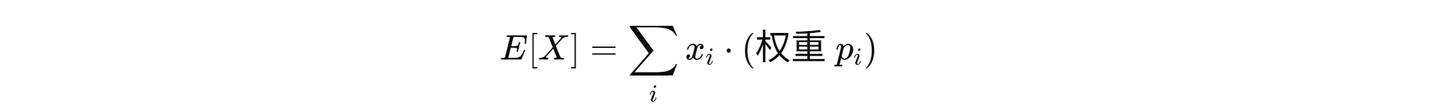
添加图片注释,不超过 140 字(可选)
例子:
添加图片注释,不超过 140 字(可选)
Pearson
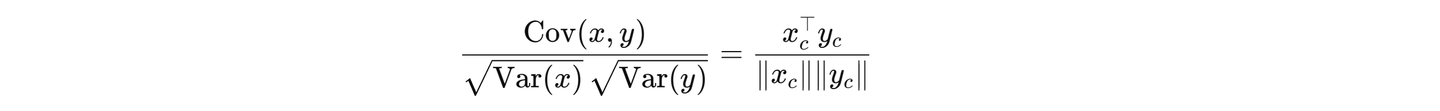
添加图片注释,不超过 140 字(可选)
这里||是L2 norm,x和y vector的欧几里得距离。
注意这里的X是用均值中心化过的,原式子长这样:
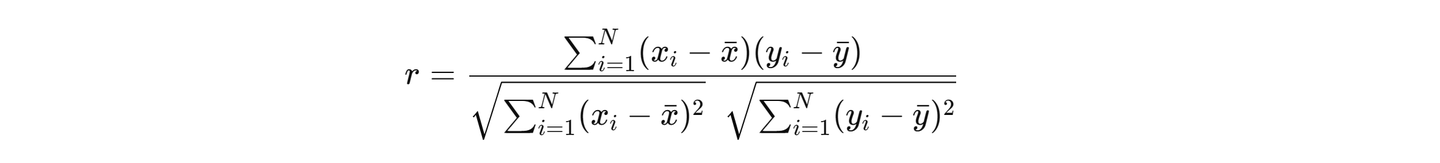
添加图片注释,不超过 140 字(可选)
那么Cov和Var里面的N-1去哪了?分母上下抵消了。
添加图片注释,不超过 140 字(可选)
Lp norm
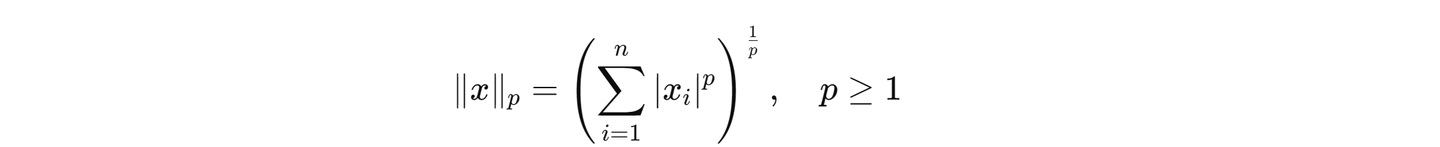
添加图片注释,不超过 140 字(可选)
L1 norm,曼哈顿距离
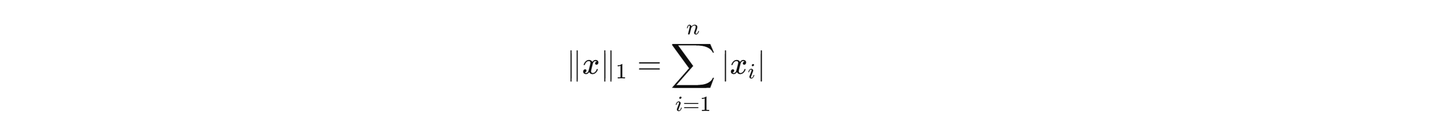
添加图片注释,不超过 140 字(可选)
L2 norm,euclidean distance
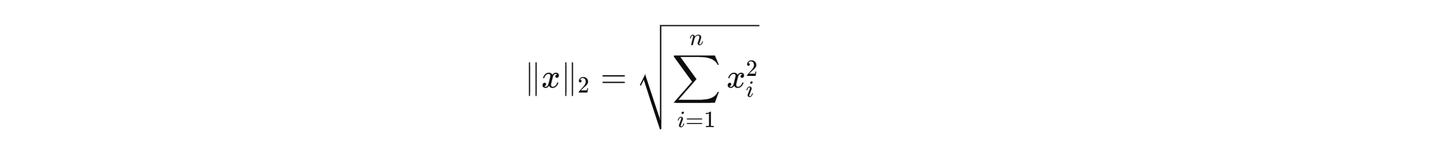
添加图片注释,不超过 140 字(可选)
p等于无限时:
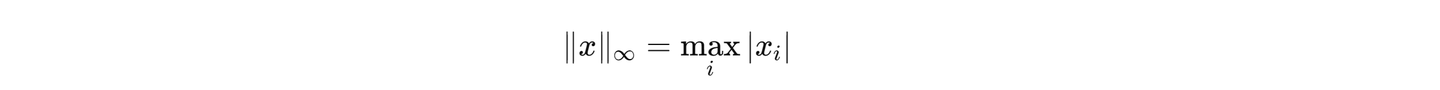
添加图片注释,不超过 140 字(可选)
很好理解,因为不断乘积会让某个值变得越来越大,最后其它值就会相对来说非常小,那么就是max了。
PCA step
数据中心化
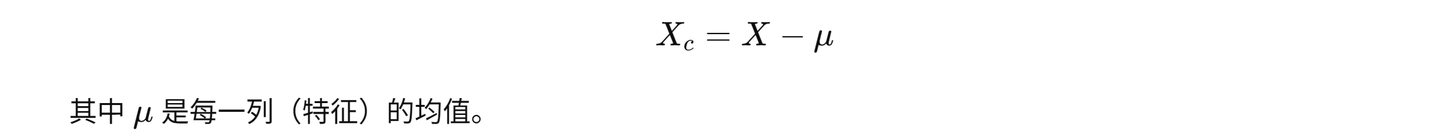
添加图片注释,不超过 140 字(可选)
计算协方差矩阵
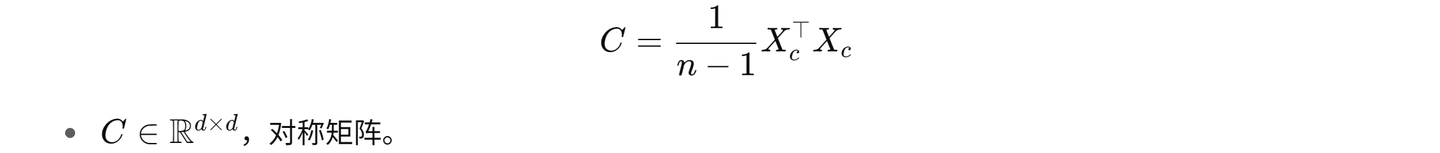
添加图片注释,不超过 140 字(可选)
对 CCC 做 特征分解 (eigen-decomposition)
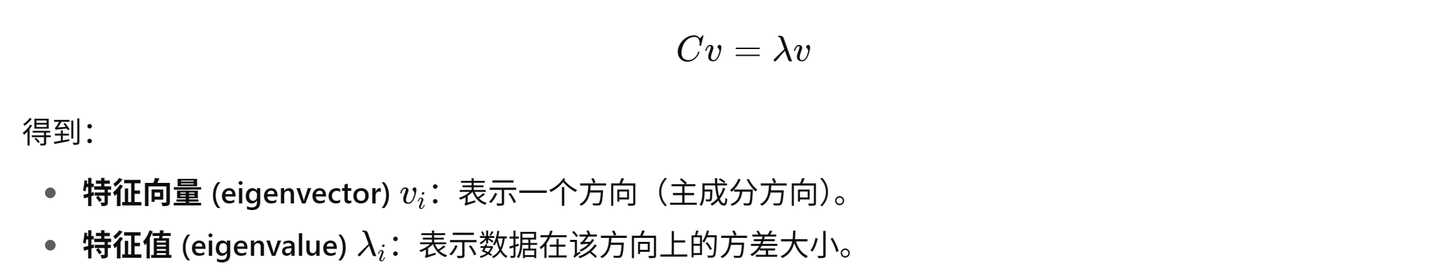
添加图片注释,不超过 140 字(可选)
排序与选取主成分

添加图片注释,不超过 140 字(可选)
投影数据
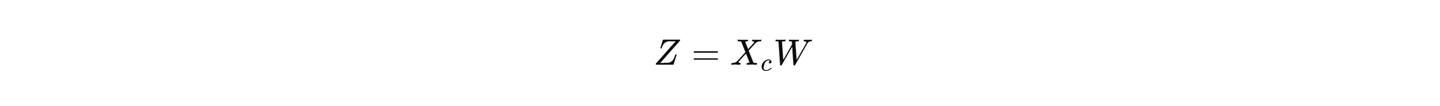
添加图片注释,不超过 140 字(可选)
SVD
公式
特征分解的另一个算法
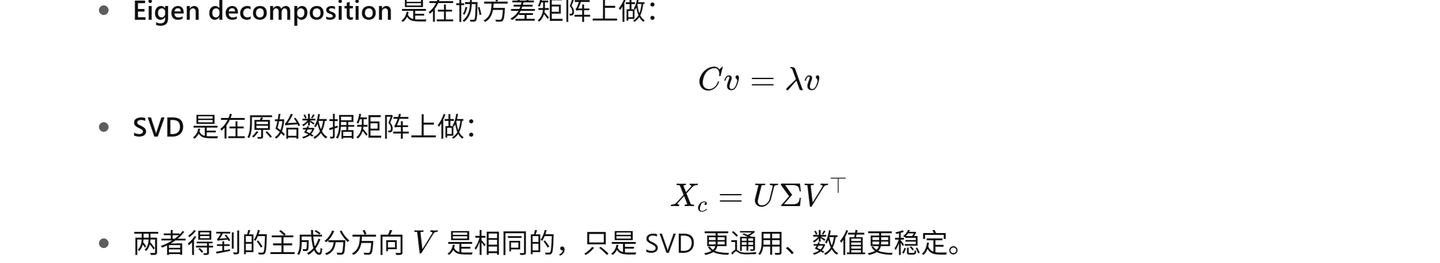
添加图片注释,不超过 140 字(可选)
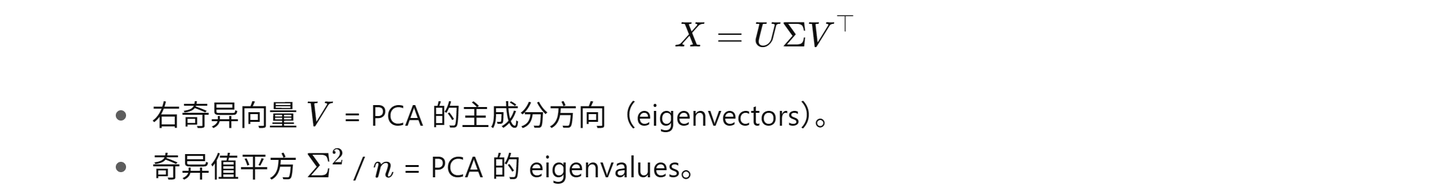
添加图片注释,不超过 140 字(可选)
SVD 直接给了我们想要的东西,比先算协方差再分解更快、更稳。
为什么用 SVD 而不是直接算特征分解?
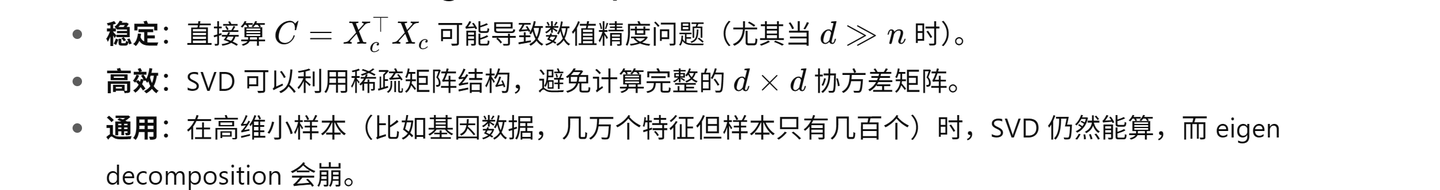
添加图片注释,不超过 140 字(可选)
Numpy里的算法
PCA的理论公式写法, 但数值不稳定,尤其当维度大时
np.linalg.eig(C)
对中心化后的数据矩阵 X 直接做 SVD
np.linalg.svd(X_c)
sklearn.decomposition.PCA 默认用 np.linalg.svd 或者scipy.linalg.svd
Truncated SVD
只计算前 k 个最大奇异值和对应的奇异向量(而不是全部)
可以直接用于稀疏矩阵,不用显式形成协方差矩阵
在文本挖掘里,Truncated SVD 就是 Latent Semantic Analysis (LSA)
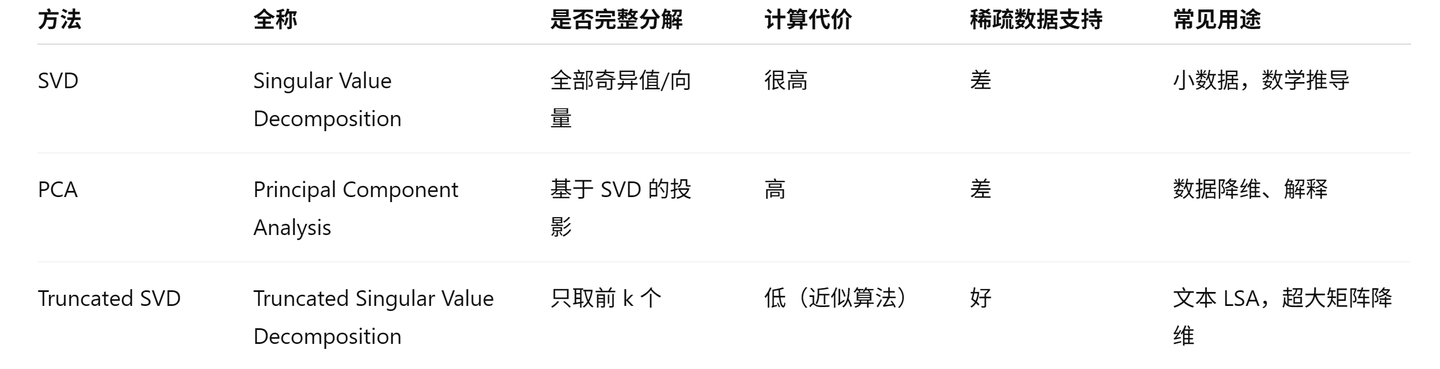
添加图片注释,不超过 140 字(可选)
sklearn.decomposition.TruncatedSVD
Contrary to PCA, this estimator does not center the data before computing the singular value decomposition. This means it can work with sparse matrices efficiently.
truncated SVD不像PCA,不会减去mean,而是由于onehot可以直接SVD
可解释性
eigenvector
可以用eigenvector解释
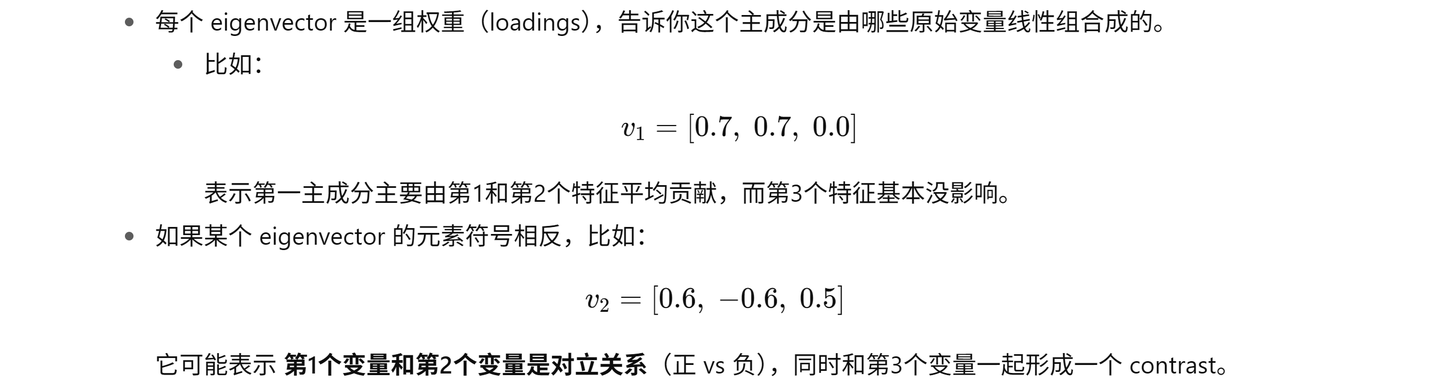
添加图片注释,不超过 140 字(可选)
例子
添加图片注释,不超过 140 字(可选)
应用
可以放在onehot做降噪和降维