Shannon entropy
公式
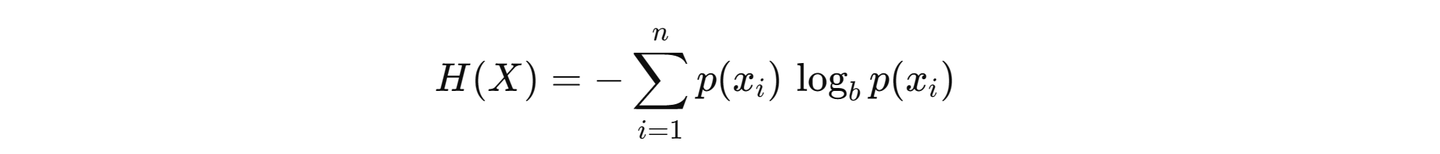
添加图片注释,不超过 140 字(可选)
entropy用H来表示
最大entropy是所有p uniform相等
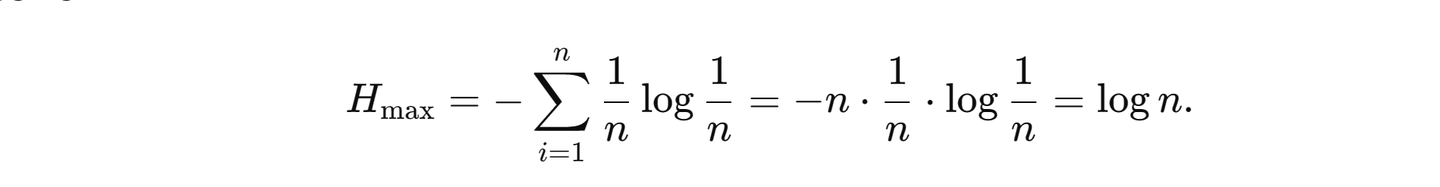
添加图片注释,不超过 140 字(可选)
Cross entropy
公式
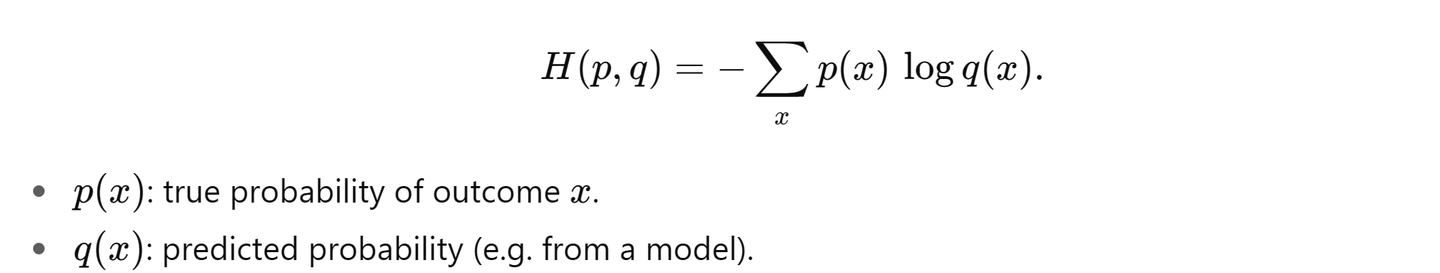
添加图片注释,不超过 140 字(可选)
用于multi-class,每个class的p加起来等于1
softmax
会让logits先过一个softmax,但根据CE里的公式log(q),后面还要加一个log, 那么可以直接log softmax
如果one-hot target (0,0,1,0) ,true label是第三位的c
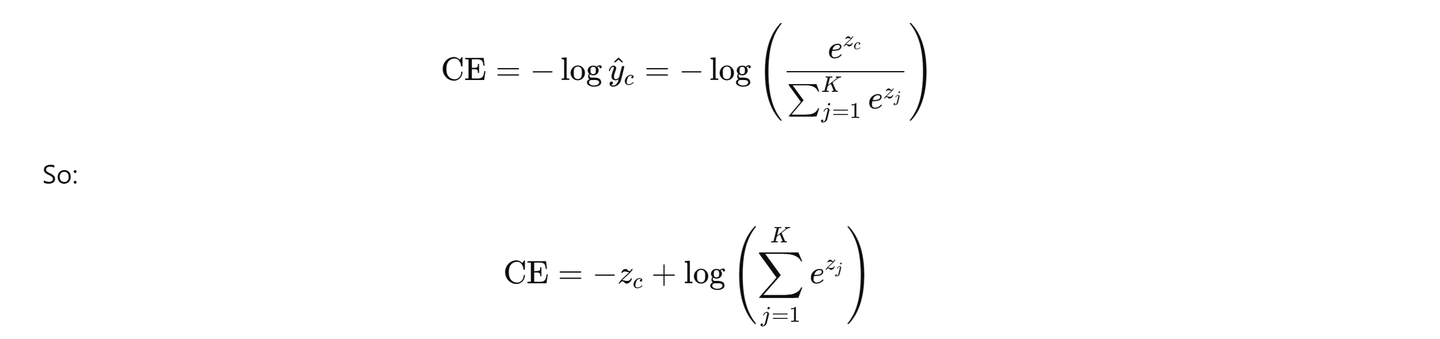
z是logits
Binary cross entropy
如果target p是binary label,1或者0, 那么就是binary cross entropy了
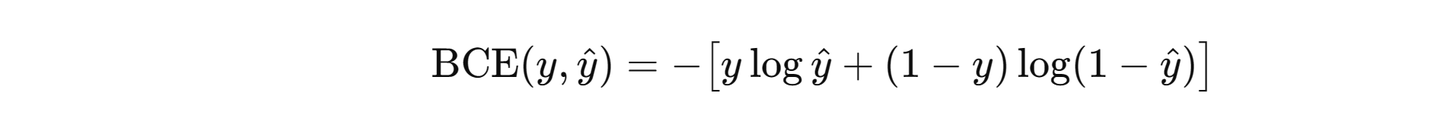
添加图片注释,不超过 140 字(可选)
y为1的时候,左边有值。y为0的时候,取右侧的那项
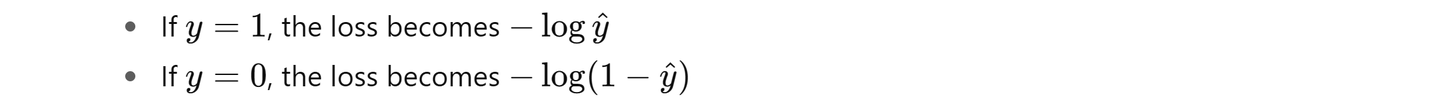
添加图片注释,不超过 140 字(可选)
Multi-label BCE
如果是multi-label BCE,那就取所有class的均值
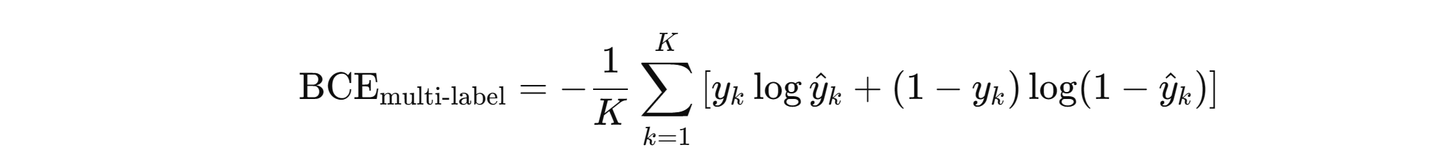
添加图片注释,不超过 140 字(可选)
一个multi-label的例子:
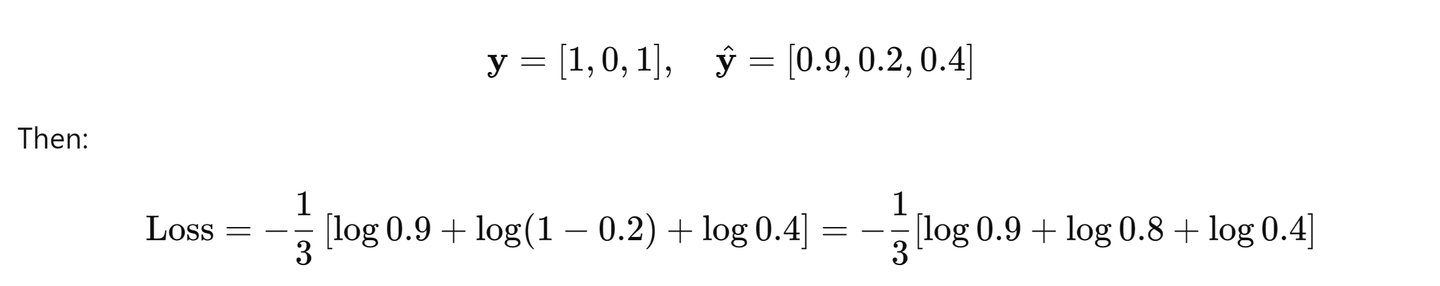
添加图片注释,不超过 140 字(可选)
pred的y会先对每个class做一个独立的sigmoid,来确保这些值在0到1区间
import torch
from torch.nn.functional import sigmoid

logits = torch.tensor([2.197, -1.386, -0.405])
probs = sigmoid(logits)
print(probs)  # → tensor([0.9000, 0.2000, 0.4000])
KL divergence
cross-entropy 最小值不为0,所以可以减去H(p)使得最小值为0,这样就变成了KL divergence。
也叫relative divergence。
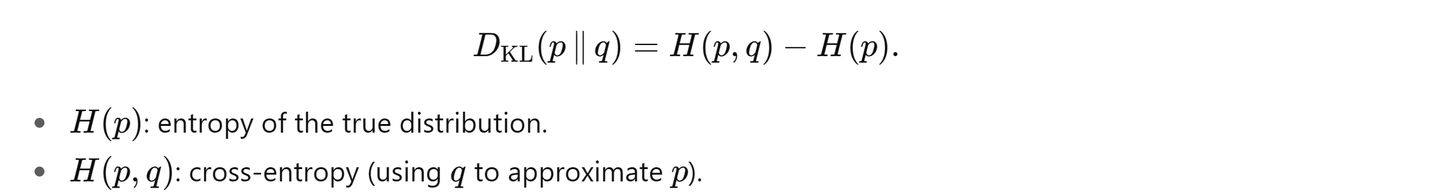
添加图片注释,不超过 140 字(可选)
带入H
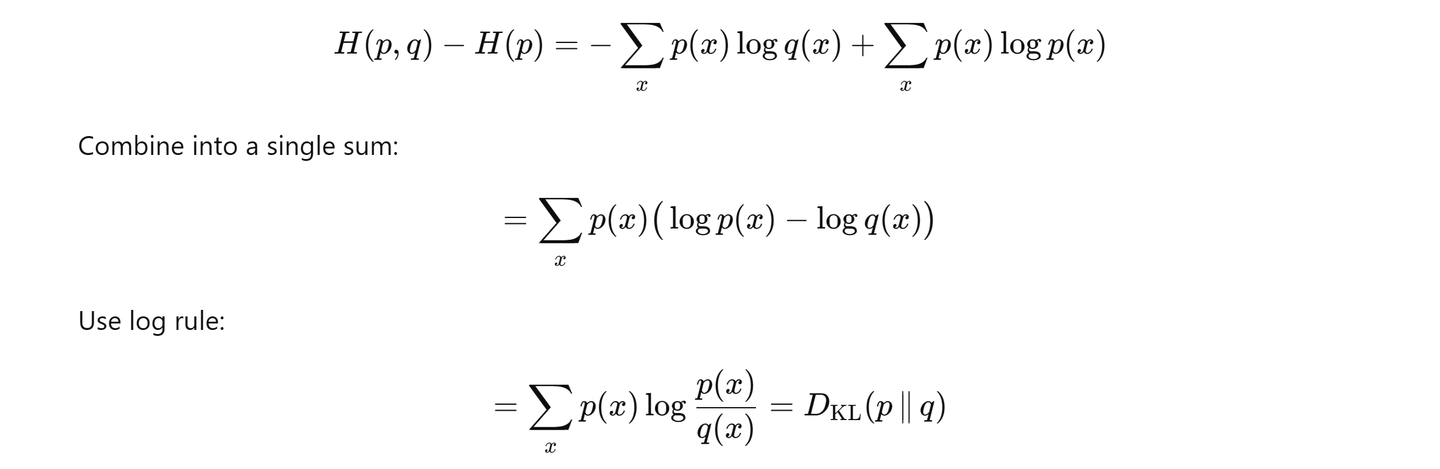
添加图片注释,不超过 140 字(可选)
所以KLD最终为:
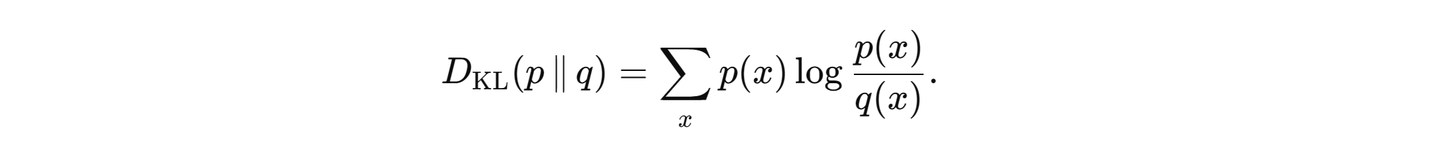
添加图片注释,不超过 140 字(可选)
JS divergence
KLD并不对称,为了有一个对称的,就有了JSD
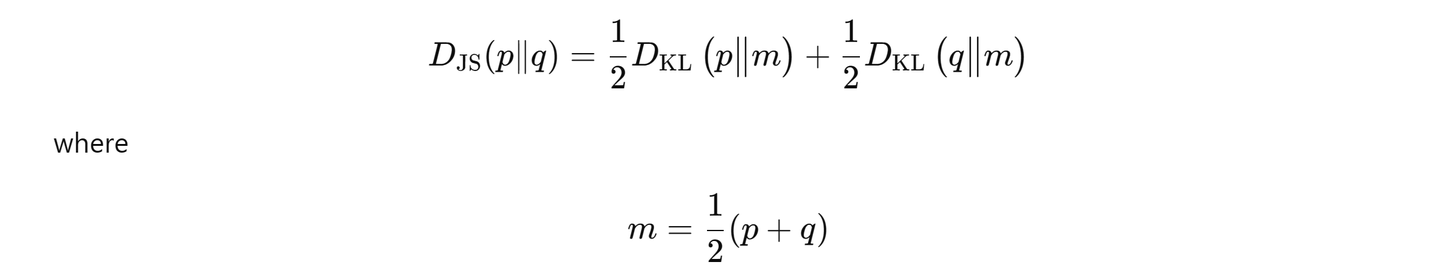
添加图片注释,不超过 140 字(可选)
value range在0到log2之间
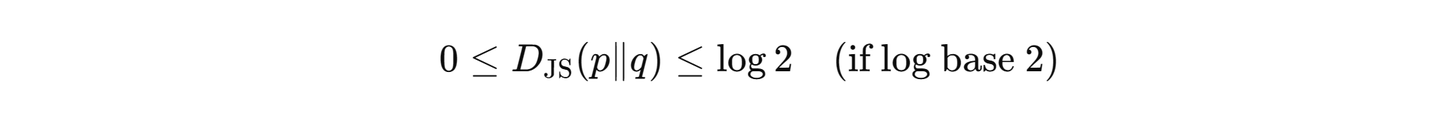
添加图片注释,不超过 140 字(可选)
因为加入p和q完全不一样:
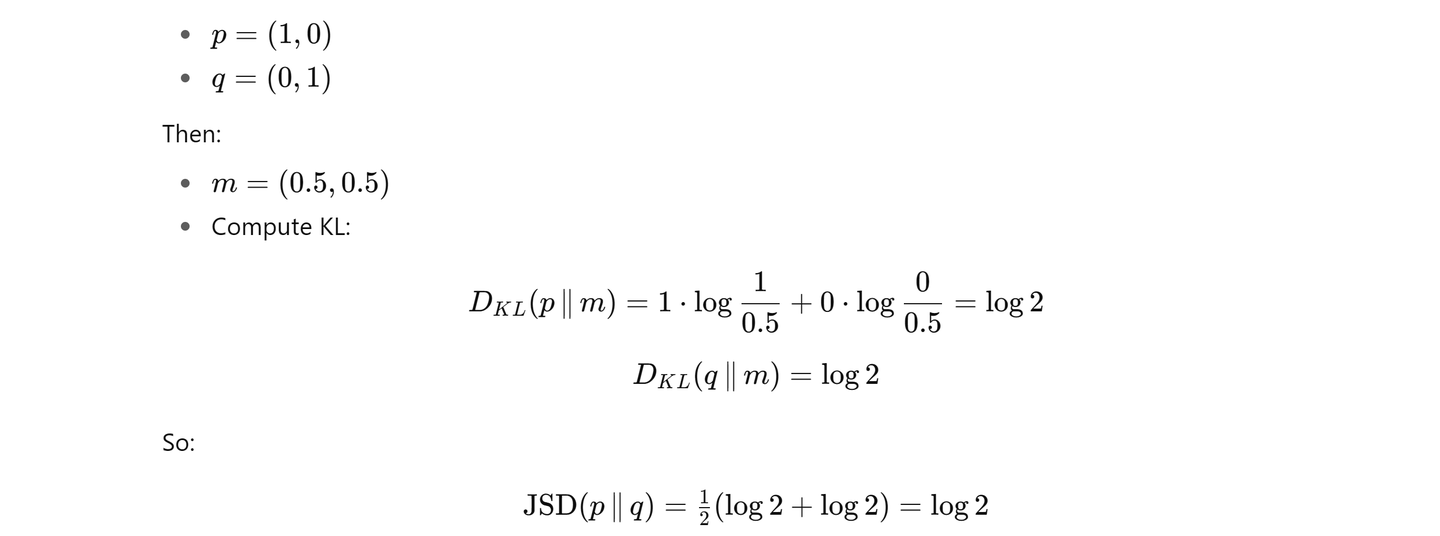
添加图片注释,不超过 140 字(可选)
JSD之于entropy
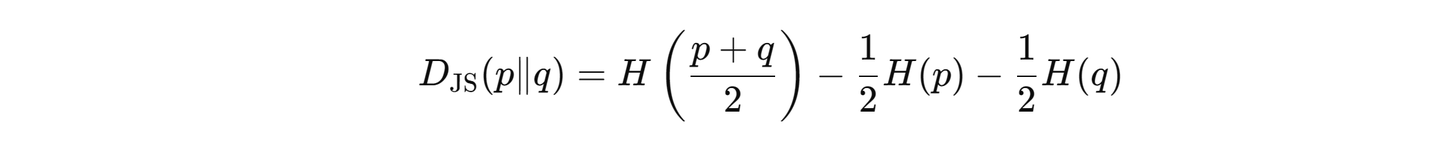
添加图片注释,不超过 140 字(可选)
mixture distribution对于 p和q的平均distribution有多远