Reference
RoPE 原论文 一作苏剑林(原追一科技,现在在月之暗面做Kimi K2模型开发)
RoPE b站讲解,from: 望舒同学 一共三个视频,目前感觉讲得最明白的
RoPE 旋转油管讲解 一个印度人讲的,后面在二维平面上如何旋转讲得很明白
Absolute Position Embedding
以前transformer用的是绝对位置编码
公式
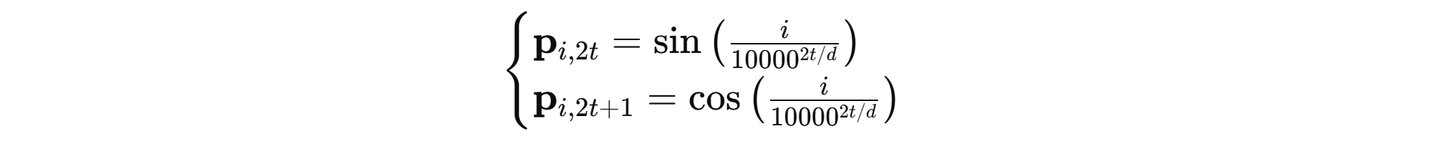
添加图片注释,不超过 140 字(可选)
-
i 是position
-
t 是pair index,就是第几个pair,每个pair是(2t,2t+1)【RoPE用k表示,一样的东西】
-
t的数值是t=[0,1,2,…,d/2−1]
-
2t的数值是 [0, 2, 4, ..., d-2]
-
d 是embedding dimension,也用d_model来表示
-
frequency是:
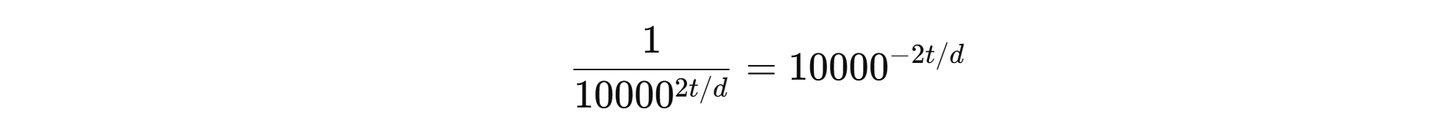
添加图片注释,不超过 140 字(可选)
随着t增长,分母越来越大,freq越来越小,从1衰减,sin(freq) 的波就会变宽。
- i position 乘以 freq 10000^(-2t/d),放在sin和cos里
position encoding matrix
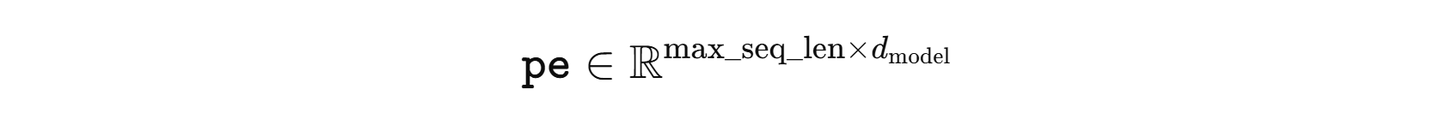
添加图片注释,不超过 140 字(可选)
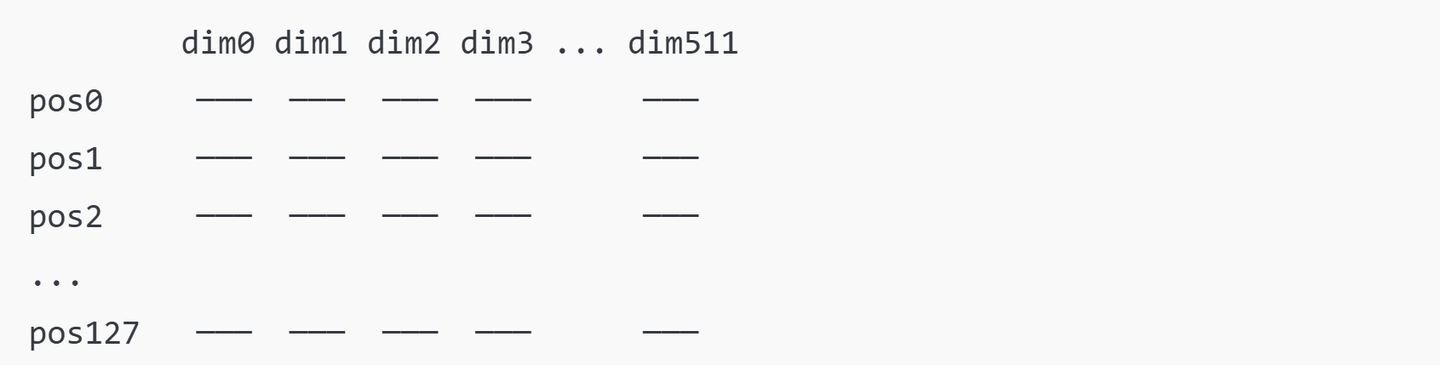
pe的结构长下面这样,可以想象dim0是一个频率为1的sin波,across all positions(下图中就是竖着的sin);然后dim1是一个频率为1的cos波,across all position,然后dim2的波宽开始比前面的大,dim越往后,freq减少,波宽越大
添加图片注释,不超过 140 字(可选)
代码
generated by chatgpt 4o
import torch
from torch import nn

class AbsolutePositionalEmbedding(nn.Module):
    def __init__(self, d_model: int, max_seq_len: int, device=None):
        """
        Sinusoidal positional encoding (absolute) as used in original Transformer.
        """
        super().__init__()
        self.d_model = d_model

        # Compute the inverse frequency term: 1 / 10000^{2t/d_model}
        position = torch.arange(max_seq_len, device=device).float().unsqueeze(1)  # (max_seq_len, 1)
        div_term = torch.exp(
            torch.arange(0, d_model, 2, device=device).float() * (-torch.log(torch.tensor(10000.0)) / d_model)
        )  # (d_model//2,)

        pe = torch.zeros(max_seq_len, d_model, device=device)
        pe[:, 0::2] = torch.sin(position * div_term)  # even indices
        pe[:, 1::2] = torch.cos(position * div_term)  # odd indices

        self.register_buffer("pe", pe, persistent=False)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        """
        Add absolute positional encoding to input tensor x.
        x: Tensor of shape (batch_size, seq_len, d_model)
        """
        seq_len = x.size(1)
        return x + self.pe[:seq_len]
代码执行的时候为了防止overflow以及快速计算,往往会进行一些变换:
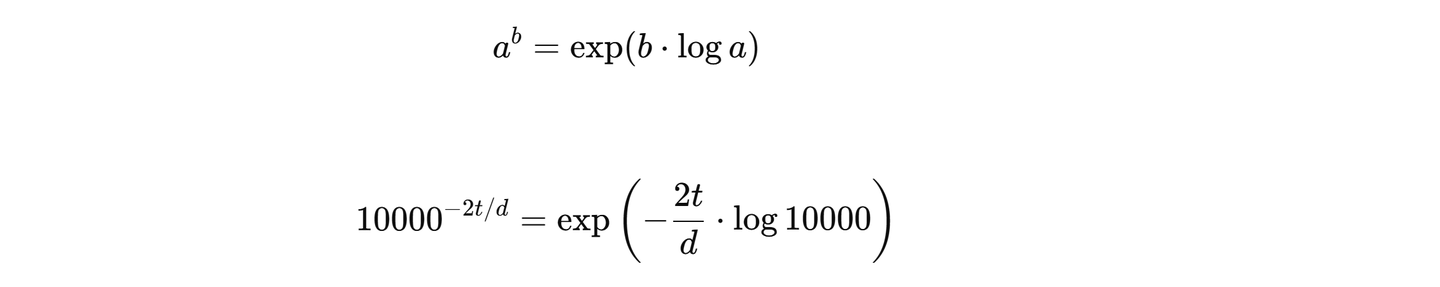
添加图片注释,不超过 140 字(可选)
这就是为什么代码里用exp和log:
        # Compute the inverse frequency term: 1 / 10000^{2t/d_model}
        position = torch.arange(max_seq_len, device=device).float().unsqueeze(1)  # (max_seq_len, 1)
        div_term = torch.exp(
            torch.arange(0, d_model, 2, device=device).float() * (-torch.log(torch.tensor(10000.0)) / d_model)
        )  # (d_model//2,)
其中
torch.arange(0, d_model, 2) # 是2t
注意算出来的pe存在buffer里,在x还没project的时候就加进去。
RoPE里,加的是proj后的Q和K。
那有没有什么方法,可以把把相对位置m-n,编码在q*k的点乘中呢?
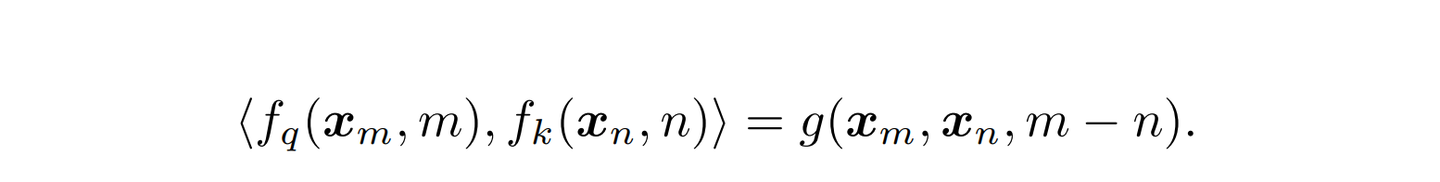
q和k在不同位置m和n的点乘,可以用相对位置m-n来表达
欧拉公式(Euler's formula)刚好可以和这个想法match。让我们复习一下欧拉公式:
欧拉公式
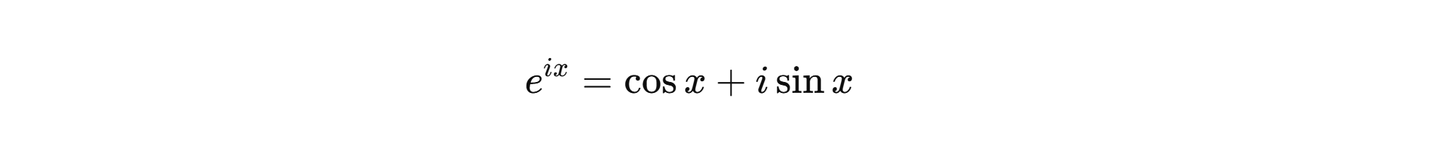
欧拉公式,cos x 是实数,右边的i sin x 是虚数,构成的e^ix是复数
二维表示的话就是
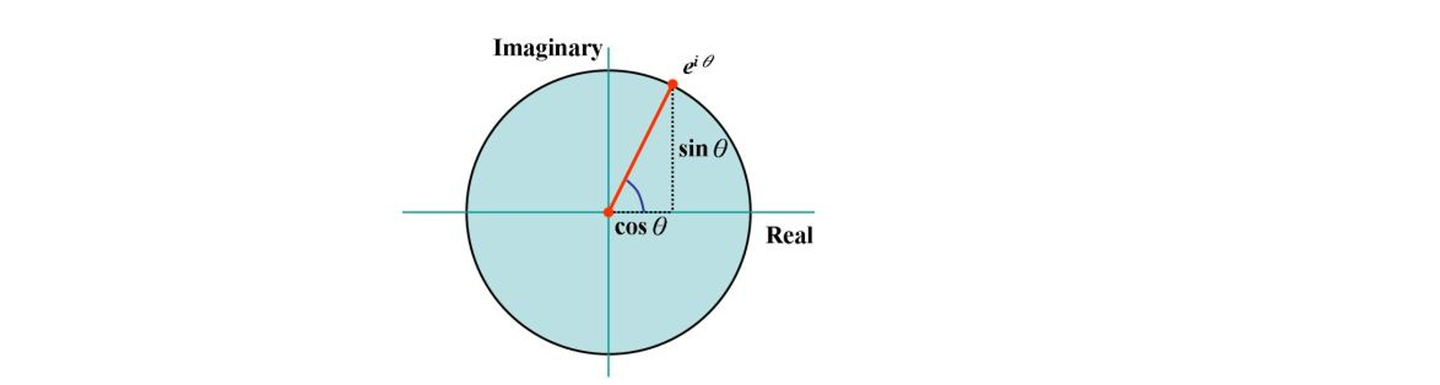
real轴是cos x, 然后imaginary轴上是i sin x
i^2 =1
1作为实数,就是在实数轴上的1。如果是纯虚数i,就是在i轴的1上,那么就是θ为π/2 (90度)的时候,可以用e^(iπ/2)表示。
那么i平方,也就是
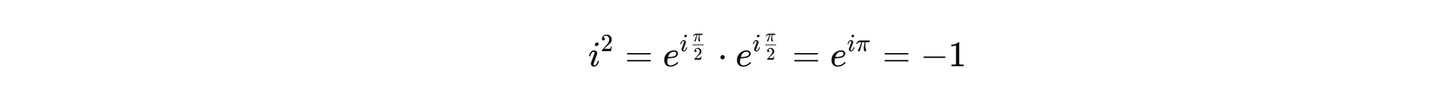
e^(iπ/2+iπ/2) = e^iπ , -180度,就落在了-1实数轴上
共轭
共轭是指一个复数的实部不变、虚部取反
比如
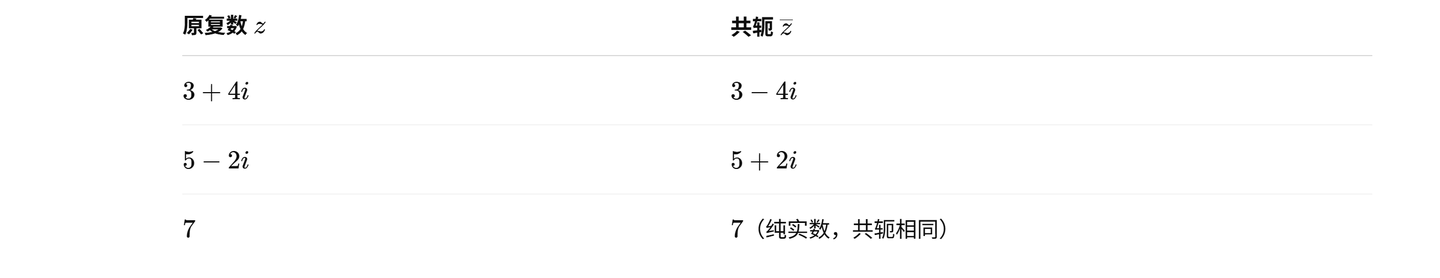
添加图片注释,不超过 140 字(可选)
复数空间中,点积需要使用一个向量的共轭
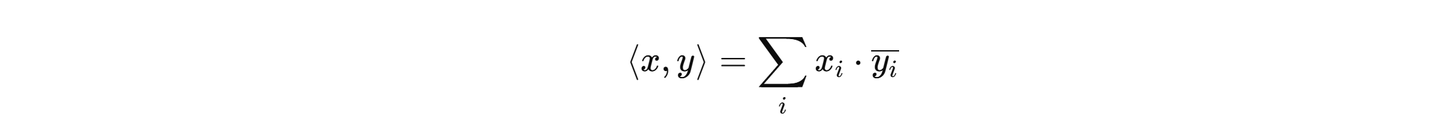
添加图片注释,不超过 140 字(可选)
RoPE
Rotary Positional Embedding,旋转位置编码
核心思想
将每个维度对变成一个二维空间中的向量(如实部+虚部),再根据位置对其进行旋转变换,以实现对位置的编码。
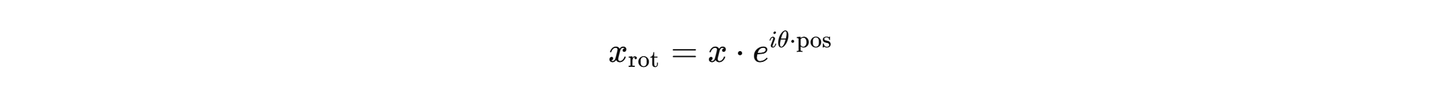
添加图片注释,不超过 140 字(可选)
另外,在q和k的点乘中,RoPE 可以将相对位置差 pos1−pos2编码进旋转角度里
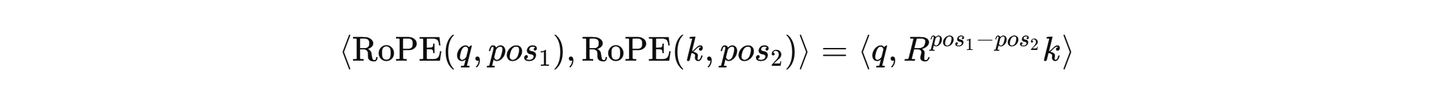
q和k是proj后的x
推导:
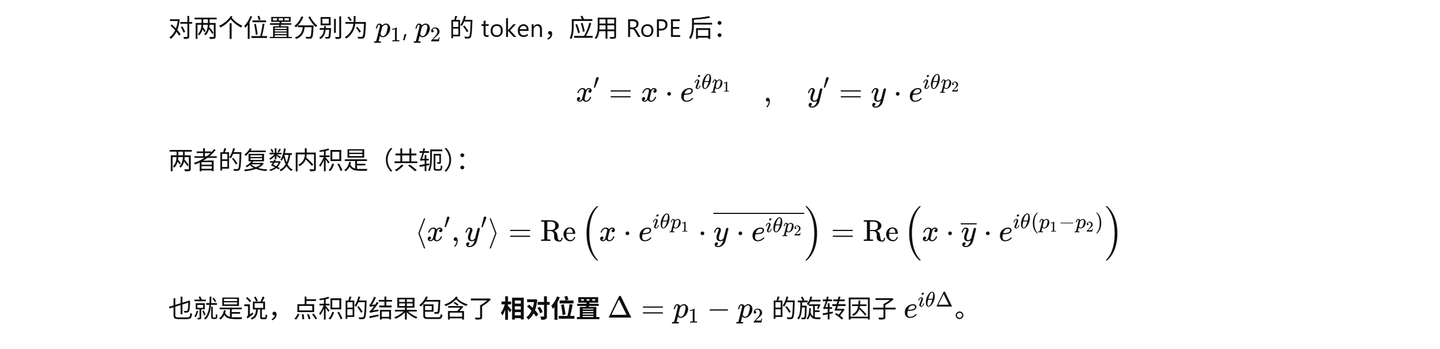
添加图片注释,不超过 140 字(可选)
建议看一下具体公式推导:RoPE b站讲解,from: 望舒同学
代码实现
import torch
from torch import nn

class RotaryPositionalEmbedding(nn.Module):
    """
    Rotary Position Embedding (RoPE) layer.

    Args
    ----
    theta : float
        Base used to generate inverse frequencies (e.g. 10_000).
    d_k : int
        Dimension of the key / query vectors (must be even).
    max_seq_len : int
        Maximum sequence length expected at inference / training time.
    device : torch.device | None
        Where to place the pre-computed sine / cosine tables.
    """
    def __init__(self,
                 theta: float,
                 d_k: int,
                 max_seq_len: int,
                 device=None):
        super().__init__()
        if d_k % 2 != 0:
            raise ValueError("d_k must be even for RoPE.")

        self.d_k = d_k
        # ---- pre-compute inverse frequencies ----
        # freq[k] = 1 / theta ** (2k / d_k)          (k = 0,1,…,d_k/2-1)
        freq= 1.0 / (theta ** (torch.arange(0, d_k, 2, device=device).float() / d_k))

        # shape: (max_seq_len, d_k // 2)
        positions = torch.arange(max_seq_len, device=device).float()
        freqs = torch.outer(positions, freq)

        # cache cos/sin; no gradients needed → persistent=False
        self.register_buffer("cos_cached", torch.cos(freqs), persistent=False)
        self.register_buffer("sin_cached", torch.sin(freqs), persistent=False)

    def forward(
        self,
        x: torch.Tensor,              # (..., seq_len, d_k)
        token_positions: torch.Tensor # (..., seq_len)
    ) -> torch.Tensor:
        """
        Apply RoPE to `x`.  Works with any batch shape prefix.
        """
        if x.size(-1) != self.d_k:
            raise ValueError(f"Last dim of x ({x.size(-1)}) ≠ d_k ({self.d_k}).")

        # Gather the cached tables for the required positions.
        # Resulting shape: (..., seq_len, d_k // 2)
        cos_pos = self.cos_cached[token_positions]
        sin_pos = self.sin_cached[token_positions]

        # Split even / odd channels.
        x_even = x[..., ::2]
        x_odd  = x[..., 1::2]

        # Apply the 2-D rotation to each pair.
        out_even = x_even * cos_pos - x_odd * sin_pos
        out_odd  = x_even * sin_pos + x_odd * cos_pos

        # Re-interleave.
        out = torch.empty_like(x)
        out[..., ::2] = out_even
        out[..., 1::2] = out_odd
        return out
解释
小R
每个小R, 是一个2x2的matrix,用来做旋转
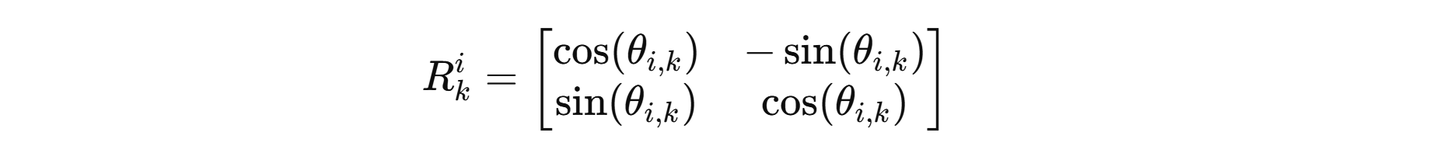
添加图片注释,不超过 140 字(可选)
-
k表示pair index
-
i是position
想完成旋转,就把小R矩阵相乘一个embedding pair (比如dim0和dim1)
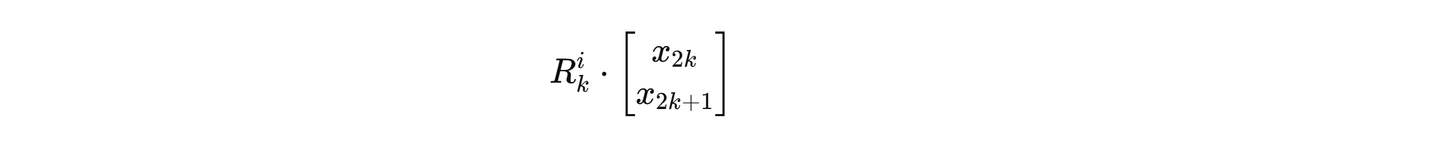
矩阵相乘
下面假如是一个projec过的k或者q
添加图片注释,不超过 140 字(可选)
假如我们固定pos1,看横着的行,从dim 0 到dim 511, 这里dim0和dim1是一对儿,我们用它们@一个小R,进行一个为θ的旋转。
如果是pos为2呢?
那么就在θ前乘一个2
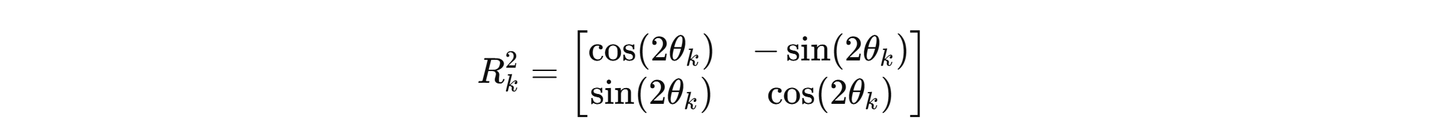
添加图片注释,不超过 140 字(可选)
固定pos2, dim0和dim1是一对儿,我们对它@一个角度变大的小R,进行一个为2θ的旋转,那么2θ之于pos1的θ的旋转就是一个θ。
如果我们把pos1和pos2的位置往后移动一位,变成了pos2和pos3,那么pos3和pos2的关系还是差一个θ的旋转,所以相对的关系不变。
这里只讨论了dim0和dim1,那么如果把所有的dim都变成一个个的pair,然后每个pair进行一个递减的旋转(递减是相对于固定position的情况下across dim)呢?
对于同一个position,但是across dimension
大R:下面的是一个大R,形状为d*d的矩阵,长括弧里面的是一个个的小R,右下的角标是k【也就是pair index:(2k,2k+1)】,所以到d/2为止
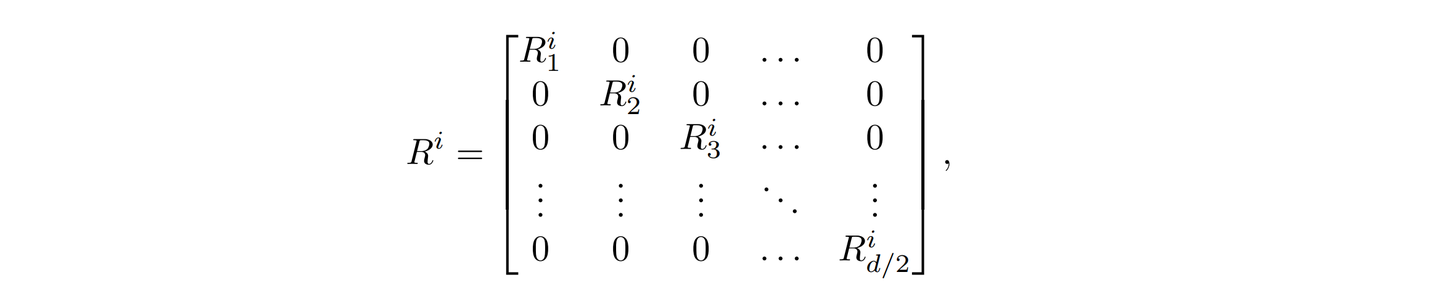
添加图片注释,不超过 140 字(可选)
把这个大的R和有d个dimension的x矩阵(embedding的linear projection)相乘,就是RoPE了。
只不过由于里面好多的0,这么做矩阵乘法不太efficient,所以会优化这个算法。
优化完变成这样,这里m是position index(之前用i表示)
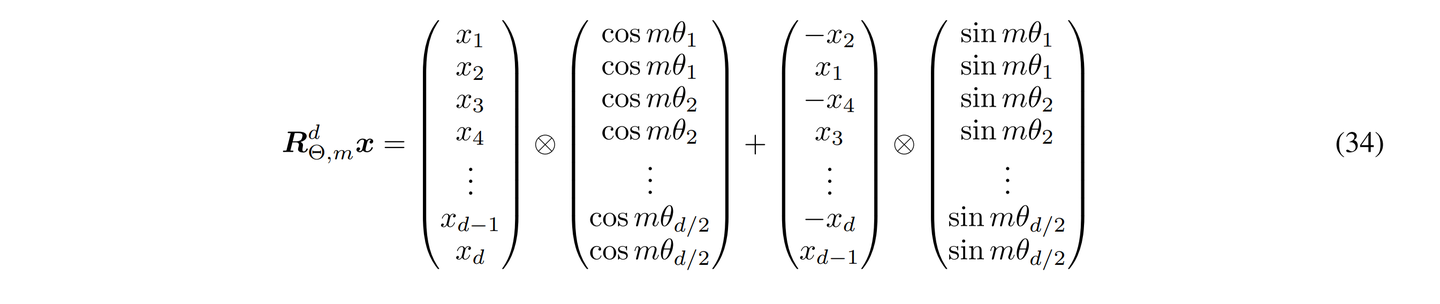
添加图片注释,不超过 140 字(可选)
假如当前position为1,+3个position的话,就是sin或cos(三倍θ)
sin和cos括弧里的东西
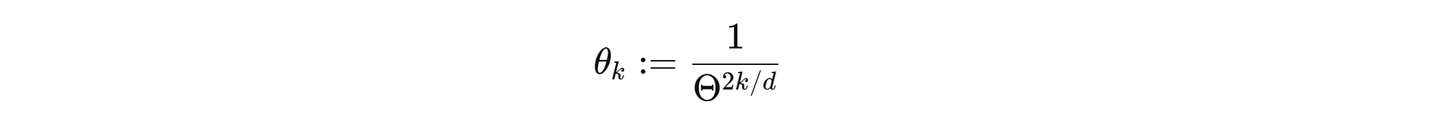
添加图片注释,不超过 140 字(可选)
-
θ 是角度
-
Θ 是常数,这里是10,000
带入10,000,发现没,和absolute embedding里面的frequency是一样的
t和k都是代表pair index
用这个θ 乘以position,就可以放到sin 和cos里面了。
代码长这样
freq= 1.0 / (theta ** (torch.arange(0, d_k, 2, device=device).float() / d_k))
positions = torch.arange(max_seq_len, device=device).float()
freqs = torch.outer(positions, freq)
让freq(a length) 和 positions (b length) 做 outer product, 结果是shape为 (a,b)的tensor
然后计算lookup tables

添加图片注释,不超过 140 字(可选)
self.cos_cached = torch.cos(freqs)
self.sin_cached = torch.sin(freqs)
带入position token
cos_pos = self.cos_cached[token_positions]  # shape (..., seq_len, d_k//2)
sin_pos = self.sin_cached[token_positions]
得到x even和x odd
x_even = x[..., ::2]
x_odd  = x[..., 1::2]
相乘
out_even = x_even * cos_pos - x_odd * sin_pos
out_odd  = x_even * sin_pos + x_odd * cos_pos
相当于矩阵乘法
添加图片注释,不超过 140 字(可选)
最后做一个空的x shape的tensor,把even 和odd放进去
out = torch.empty_like(x)
out[..., ::2] = out_even
out[..., 1::2] = out_odd
最后return out即可