Basics
cross entropy loss
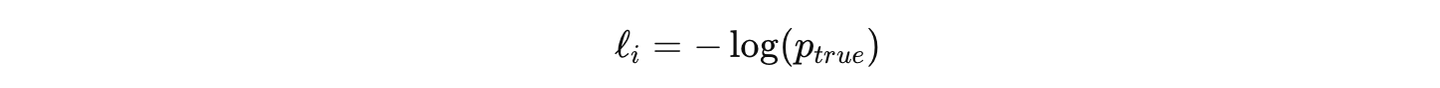
添加图片注释,不超过 140 字(可选)
针对每个 batch的 average loss
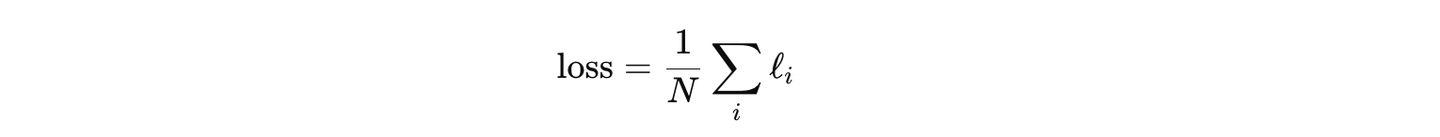
添加图片注释,不超过 140 字(可选)
N = batch size(样本数),ℓi = 第 i 个样本的 loss
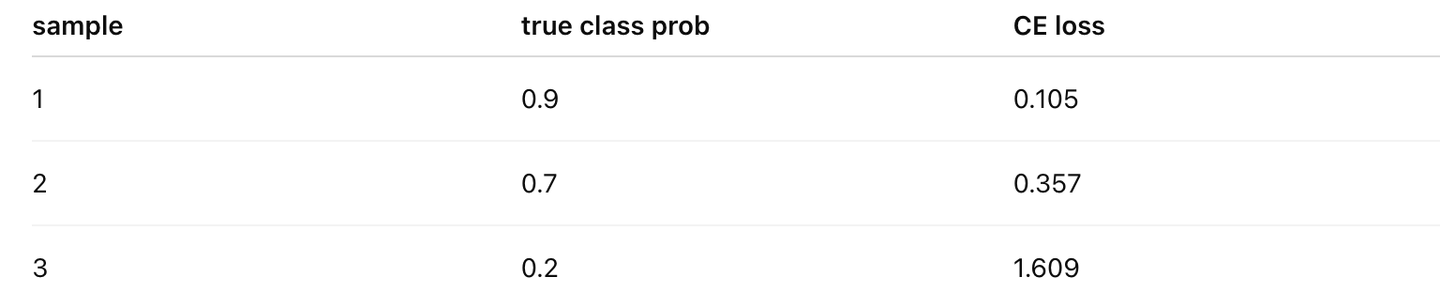
假如 batch 是 3
添加图片注释,不超过 140 字(可选)
对样本平均
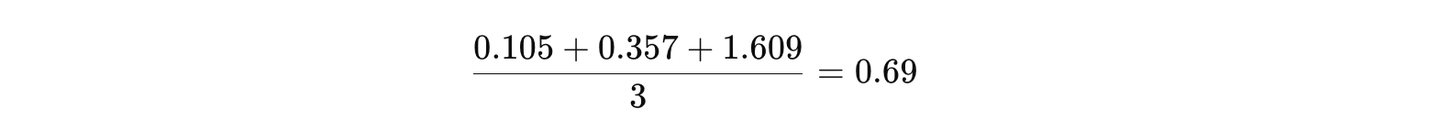
添加图片注释,不超过 140 字(可选)
SGD
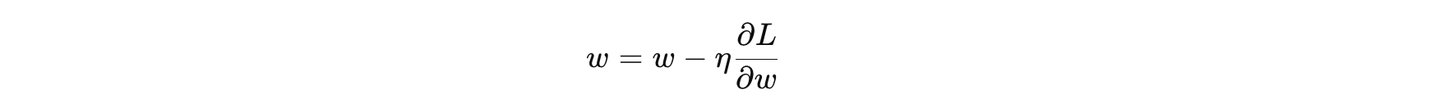
添加图片注释,不超过 140 字(可选)
Momentum SGD
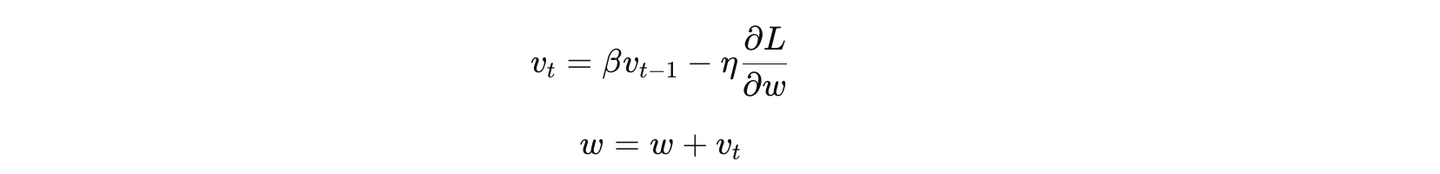
添加图片注释,不超过 140 字(可选)
展开
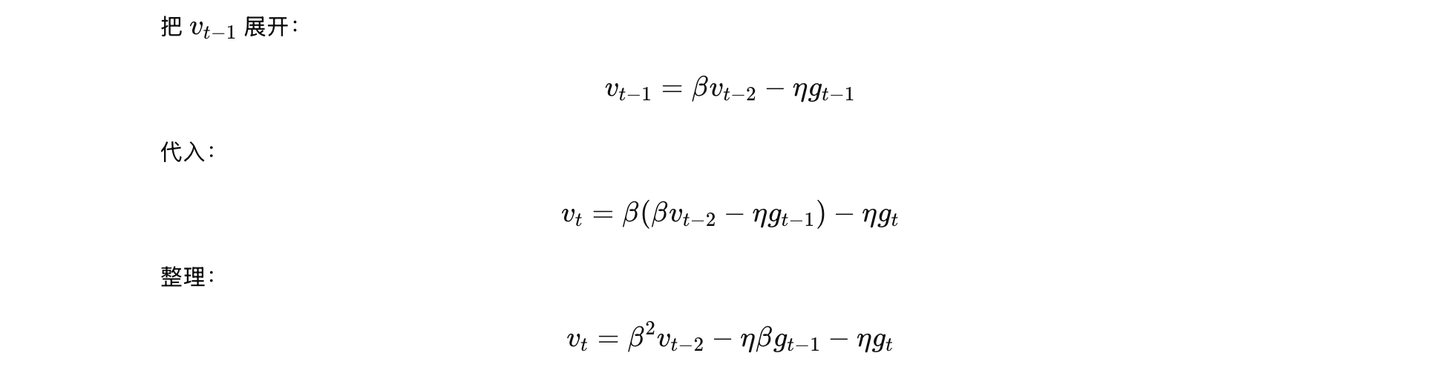
添加图片注释,不超过 140 字(可选)
以此类推
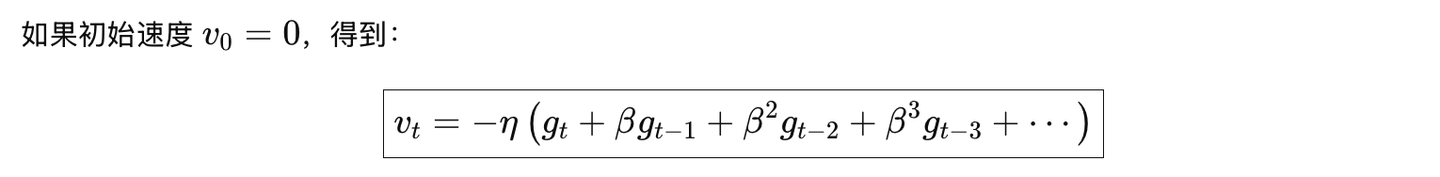
添加图片注释,不超过 140 字(可选)
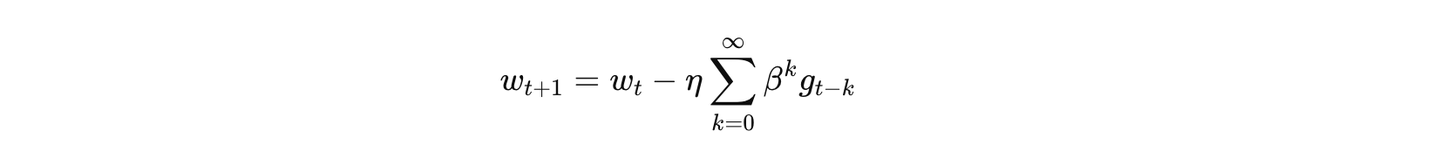
添加图片注释,不超过 140 字(可选)
权重和
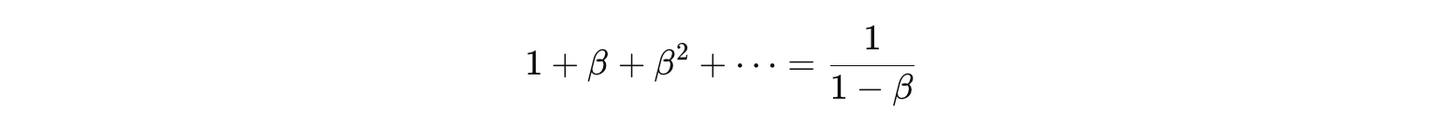
添加图片注释,不超过 140 字(可选)
这个数是>1 的,如果 beta=0.9, 所有方向一致,就是 10 倍加速,如果 beta=0.99,就是 100 倍加速。
不像 EMA,权重和为 1.
EMA
Exponential Moving Average(指数移动平均)
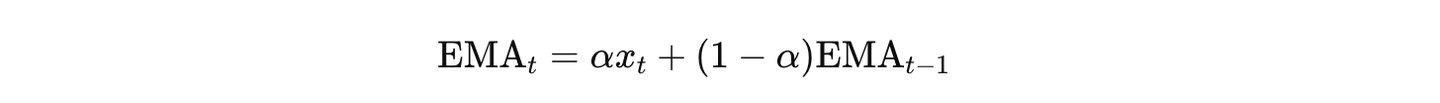
添加图片注释,不超过 140 字(可选)
展开后,权重加起来为 1
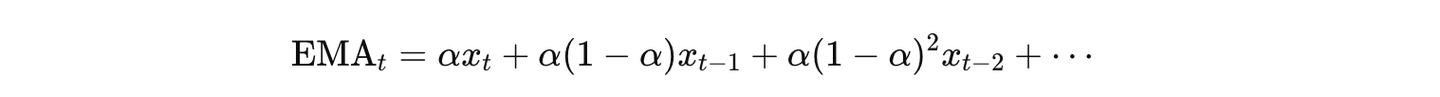
添加图片注释,不超过 140 字(可选)
reweight
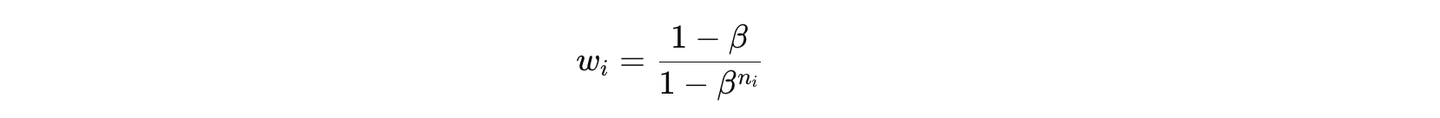
添加图片注释,不超过 140 字(可选)
然后要 normalize,所以除以 wi 的 sum,但又要确保 average loss 是 1,所以要乘以 number of class
w = w / w.sum() * num_classes
不乘以 num classes 的话
w=w/w.sum() # → [0.016, 0.082, 0.902]
这个例子的平均 weight 是 0.33, 然后乘以 loss,整体的 loss会变小,那么梯度下降的速度就会变小,需要同时 adjust lr 之类的,所以要乘以 num_classes
公式怎么来的?
每个新样本增加的信息越来越少。
每个样本贡献比例 = β, β 越接近 1 → 重叠程度高,第 n 个样本带来的新增信息,beta^n-1
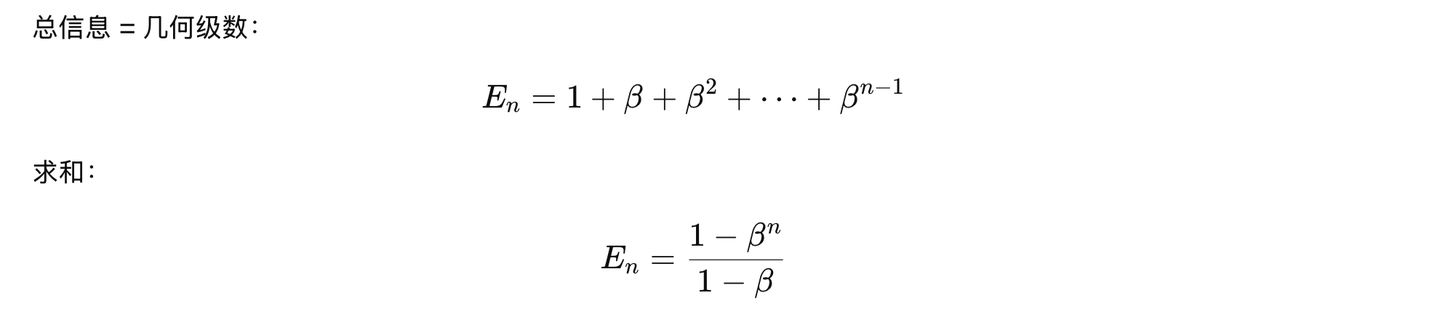
添加图片注释,不超过 140 字(可选)
En是有效信息量。有效信息量越多,权重越少,有效信息量越少,权重越多。所以是 inverse 的关系
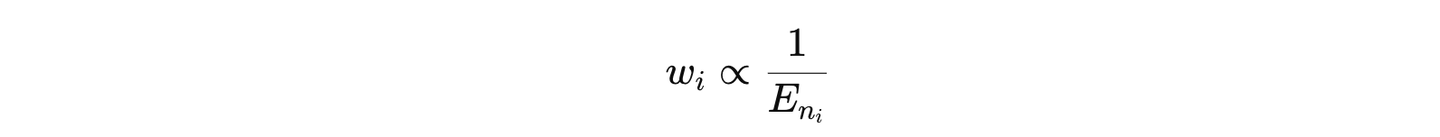
添加图片注释,不超过 140 字(可选)
上下倒过来,就是 w 了。
focal loss
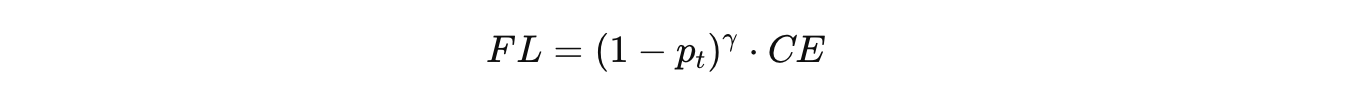
添加图片注释,不超过 140 字(可选)
pt 是 P(truth),γ是 focus length
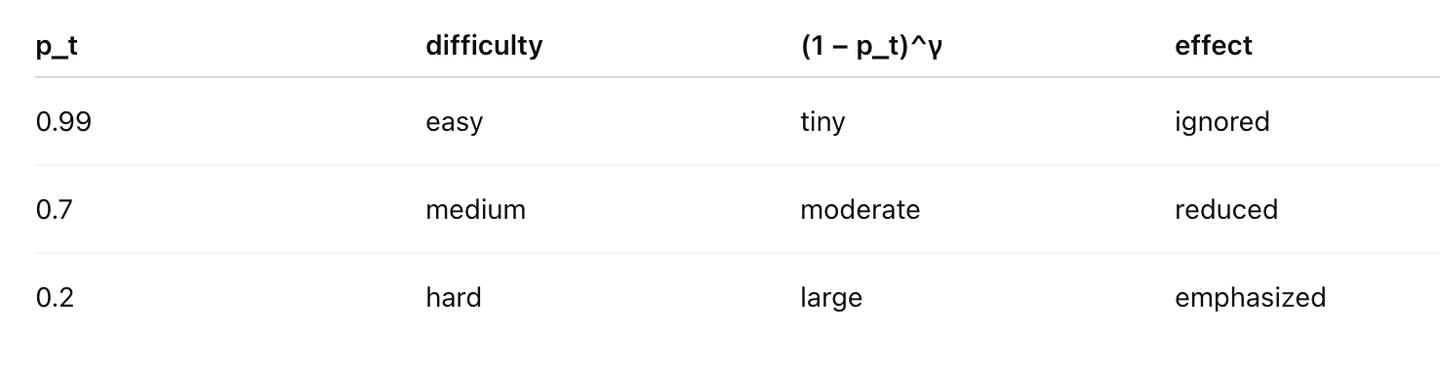
添加图片注释,不超过 140 字(可选)
Convolution
kernel, stride
output的 size 是 (input length - kernel_size)//stride +1, 后面+1 是因为 n=0 也算。
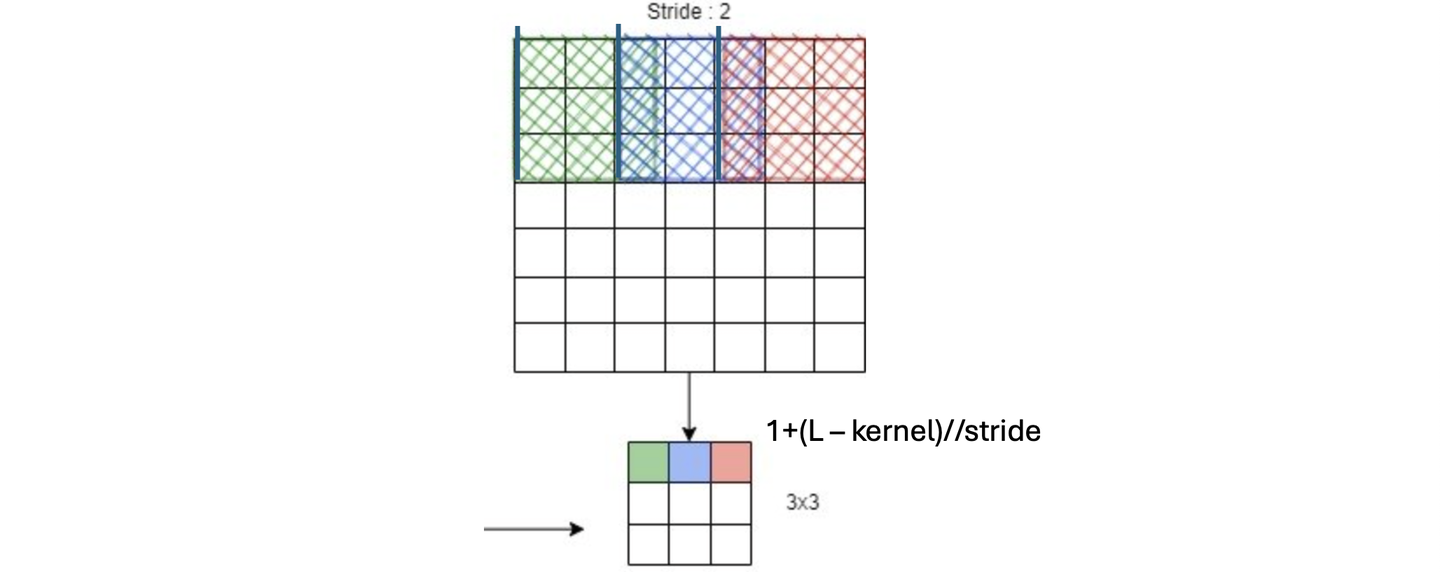
添加图片注释,不超过 140 字(可选)
下面这个是一个stride为1的时候的例子
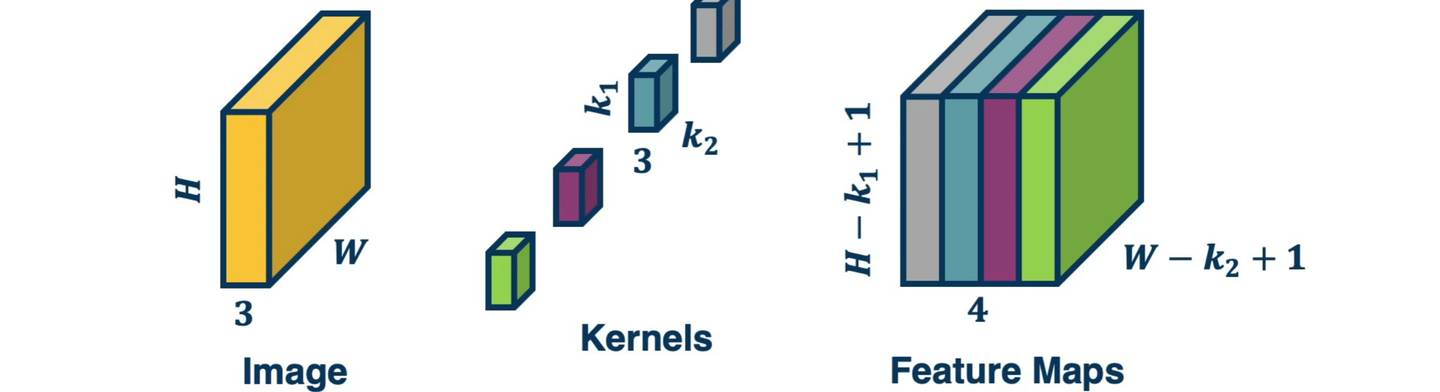
添加图片注释,不超过 140 字(可选)
deeper layers 靠近输出 / loss, 能看到更复杂图案。第一层: 只看 3×3 像素 ;第二层: 看第一层组合 → ~5×5 区域; 第三层: ~9×9 更深层:可覆盖整个物体。
kernel
内部相乘的sum, 会把 3 个通道 全部相加
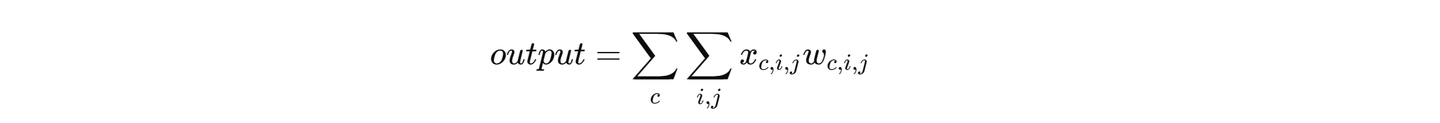
添加图片注释,不超过 140 字(可选)
# 3通道输入 (比如RGB)
x = np.random.rand(3, 4, 4)

# 3通道 kernel
k = np.random.rand(3, 2, 2)

patch = x[:, 0:2, 0:2]

out = np.sum(patch * k)

输入:  (3, H, W)
kernel: (64, 3, 3, 3)

输出:  (64, H_out, W_out)
64这里是64个kernel。每个 kernel 都有自己独立学习到的权重。
权重共享(weight sharing)是指kernel在整张图上滑动,在每个位置使用 同一组权重。
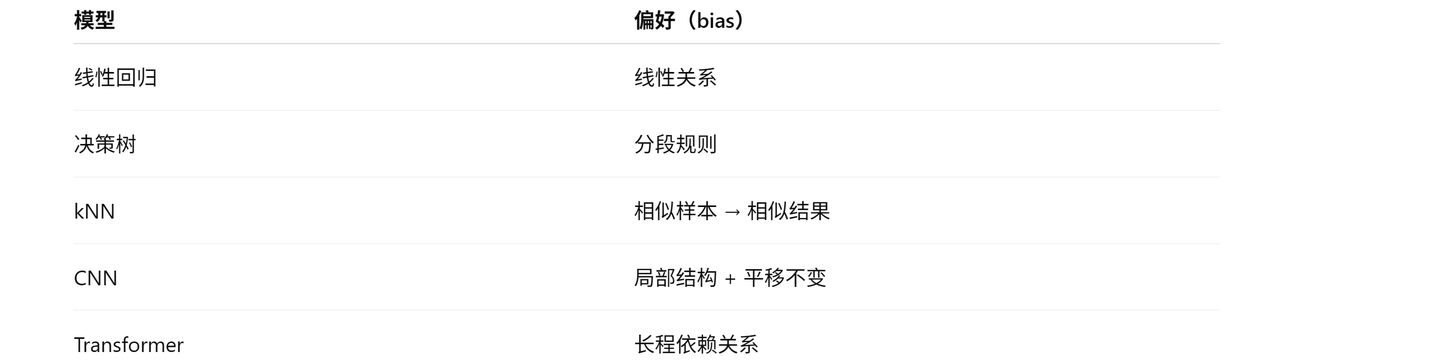
Inductive bias指模型在学习前就内置的假设。现实问题: 训练数据永远不可能覆盖所有情况 模型必须“猜测”未知情况。 这种“猜测方向”来自 inductive bias。